"이 모델 NVFP4로 양자화했어요."
혹시 이런 문장을 보고 멈칫하신 적 있나요? 양자화는 노타가 다루는 핵심 기술 중 하나라 노타 블로그에도 자주 나오는데요. 정작 무슨 뜻인지 물어보면 선뜻 답하기 어렵죠. 사실 그동안 저도 "뭐, 모델에서 뭔가를 잘라내서 작게 만들었나 보다" 정도로만 생각했어요.
명색이 노타의 마스코트인데, 양자화에 대해서만큼은 제대로 알아야겠다고 생각해서 이번 기회에 꼼꼼히 공부해 봤어요. 혼자만 알기엔 아까우니 제가 공부한 걸 하나씩 알려 드릴게요.
교과서적인 정의부터 보면, 양자화(quantization)는 AI 모델이 계산에 쓰는 숫자를 더 적은 비트로 표현해서 모델 크기와 계산량을 함께 줄이는 경량화 기법이에요. 벌써 머리가 살짝 복잡해지죠? 괜찮아요. 지금부터 천천히 하나씩 풀어 볼게요.
양자화를 이해하려면 왜 필요한지부터 아는 게 좋아요. 예를 하나 들어 볼게요. 노타중학교 3학년 남학생 100명의 평균 몸무게를 구해야 한다고 해 볼게요. 우리에게는 체중계가 두 개 있어요. 하나는 소수점 첫째 자리까지 나오는 체중계, 다른 하나는 정수까지만 나오는 체중계예요.
정수 체중계로 재면 학생 한 명 한 명의 몸무게는 조금 덜 정확해요. 그런데 100명의 평균을 내 보면 어떨까요? 몸무게를 반올림하면서 조금 올라간 숫자와 조금 내려간 숫자가 섞여서, 숫자 하나하나는 덜 정확해도 평균이라는 전체 결과는 거의 같을 거예요. 만약 우리에게 필요한 정보가 오직 '평균 몸무게'라면, 굳이 모든 숫자를 소수점까지 적을 필요가 있을까요?
AI 모델도 비슷해요. AI 모델은 수십억에서 수천억 개의 숫자로 이루어져 있고, 이 숫자들은 보통 0.027341…처럼 소수점 아래 여러 자리까지 정밀하게 저장돼 있어요. 체중계에서 평균이 거의 같았던 것처럼, 숫자 하나하나를 조금 덜 정밀하게 적어도 모델의 성능이 크게 떨어지지 않는 경우가 많아요.
그런데 숫자를 더 적은 비트로, 그러니까 더 짧게 적으니까 모델 전체는 가벼워져요. 모델이 가벼워지면 스마트폰 같은 작은 기기에서도 돌릴 수 있고, 서버에서는 필요한 GPU가 줄어요. 이게 양자화가 필요한 이유예요.
어때요? 처음엔 외계어 같던 정의가 이제 좀 다르게 보이지 않나요? 아까 그 정의를 다시 읽어 보면, "숫자를 더 적은 비트로 표현해서 모델 크기와 계산량을 줄인다"는 말은 숫자를 조금 덜 정밀하게 표현해서 모델을 가볍게 만든다는 뜻이에요. 몸무게를 소수점 대신 정수로 적은 것처럼요.
체중계에서는 눈금이 소수점 첫째 자리냐 정수냐에 따라 적는 숫자가 달라졌죠. 이처럼 눈금을 성기게(간격을 넓게) 만들어 더 적은 종류의 값으로 표현하는 것을 양자화의 기본 원리라고 볼 수 있어요.
자로 길이를 재는 상황으로 조금 더 자세히 볼게요. 길이가 12.37cm인 물건이 있어요. 눈금이 0.01cm 단위로 촘촘한 자로 재면 12.37이라고 그대로 적을 수 있어요. 0.1cm 단위 자로 재면 가장 가까운 눈금인 12.4로, 1cm 단위 자로 재면 12로 적게 되죠.
눈금이 성길수록 표현할 수 있는 값이 줄어들어요. 12.37이 12.4나 12처럼 더 거친 값으로 바뀌는 거죠. 대신 원래 값과는 조금씩 달라져요. 12.4는 원래 값과 0.03, 12는 0.37만큼 차이가 나요. 이렇게 가장 가까운 눈금에 맞춰 적으면서 생기는 차이가 양자화 오차예요.
위 예시처럼 숫자 하나만 보면 크게 와닿지 않지만, 모델 안에는 0.0273, 0.0315, 0.0098처럼 값이 제각각인 숫자가 수십억 개 들어 있어요. 이 숫자들에도 같은 방식으로 눈금을 그어 볼게요. 숫자들이 대부분 0에서 0.03 사이에 있으니, 0부터 0.03까지 0.01 간격으로 눈금을 그으면 0, 0.01, 0.02, 0.03, 이렇게 네 개의 눈금이 생겨요.
이제 원래 숫자 16개를 각각 가장 가까운 눈금 값으로 바꿔 적어요. 예를 들어 0.0273과 0.0315는 모두 0.03으로 바뀌는 식이에요. 숫자의 개수는 16개 그대로지만, 숫자가 가질 수 있는 값은 네 개의 눈금으로 제한되는 거죠. 원래 숫자 대신 바꿔 적은 값만 남기니, 제각각이던 16가지 값이 4가지로 줄어들면서 모델도 가벼워지는 거예요.
앞에서 숫자들이 가질 수 있는 값을 눈금 4개로 줄여 봤어요. 실제 양자화에서는 몇 가지 값까지 표현할 수 있는지를 비트 수로 정해요. 컴퓨터는 숫자를 0과 1로 적는데, 이 한 자리를 비트라고 해요.
비트를 어렵게 생각하지 않아도 돼요. 비트가 하나 늘 때마다 표현할 수 있는 값이 두 배가 된다는 것만 기억하면 돼요. 2비트면 4가지, 4비트면 16가지, 8비트면 256가지예요. 그림 2처럼 눈금이 네 개라면 숫자 하나를 2비트로 적을 수 있죠.
AI 관련 글을 읽다 보면 INT8, FP8, NVFP4 같은 표현을 본 적이 있을 거예요. 저는 처음에 무슨 암호인 줄 알았어요. 모두 양자화할 때 쓰는 숫자 형식, 즉 포맷의 이름인데요. 뒤의 숫자는 비트 수, 앞부분은 숫자를 표현하는 방식이에요. INT(정수)는 일정한 간격으로 값을 표현하고, FP(부동소수점)는 값의 크기에 따라 표현하는 간격이 달라져요. 자에 비유하면 INT는 눈금 간격이 모두 같은 자이고, FP는 작은 값 쪽은 눈금이 촘촘하고 큰 값으로 갈수록 간격이 넓어지는 자예요.
표 2의 '주로 쓰는 곳'을 보면 포맷마다 쓰이는 곳이 다르죠. 그 이유 중 하나는 칩이에요. 양자화한 모델은 칩과 소프트웨어가 그 포맷을 효율적으로 계산할 수 있어야 실제로 빨라지거든요. 예를 들어 INT8은 대부분의 칩이 지원하지만, FP8과 NVFP4는 최신 GPU 등 일부 하드웨어에서만 빠르게 계산할 수 있어요. 그래서 포맷을 고를 때는 모델을 돌릴 칩도 함께 봐야 해요.
양자화는 성능을 최대한 지키면서 모델을 가볍게 만드는 기술이라고 했죠. 그럼 실제로 얼마나 가벼워질까요? 핵심은 앞에서 본 비트 수예요.
모델이 학습하면서 정해 둔 숫자를 파라미터라고 하고, 그중 대부분을 차지하는 게 가중치예요. 파라미터가 70억 개인 모델(7B)을 FP32로 저장하면 숫자 하나가 4바이트(32비트)라, 숫자를 저장하는 데만 약 28GB가 필요해요. FP16이면 약 14GB, INT8이면 약 7GB, INT4면 약 3.5GB로 줄어요. 비트 수가 절반이 될 때마다 용량도 절반이 되는 거죠. 28GB짜리는 제 노트북으로는 버겁지만, 3.5GB라면 해 볼 만하겠더라고요. (실제로 모델을 돌릴 때는 계산 중간값 등을 담을 메모리가 여기에 더 필요해요.)
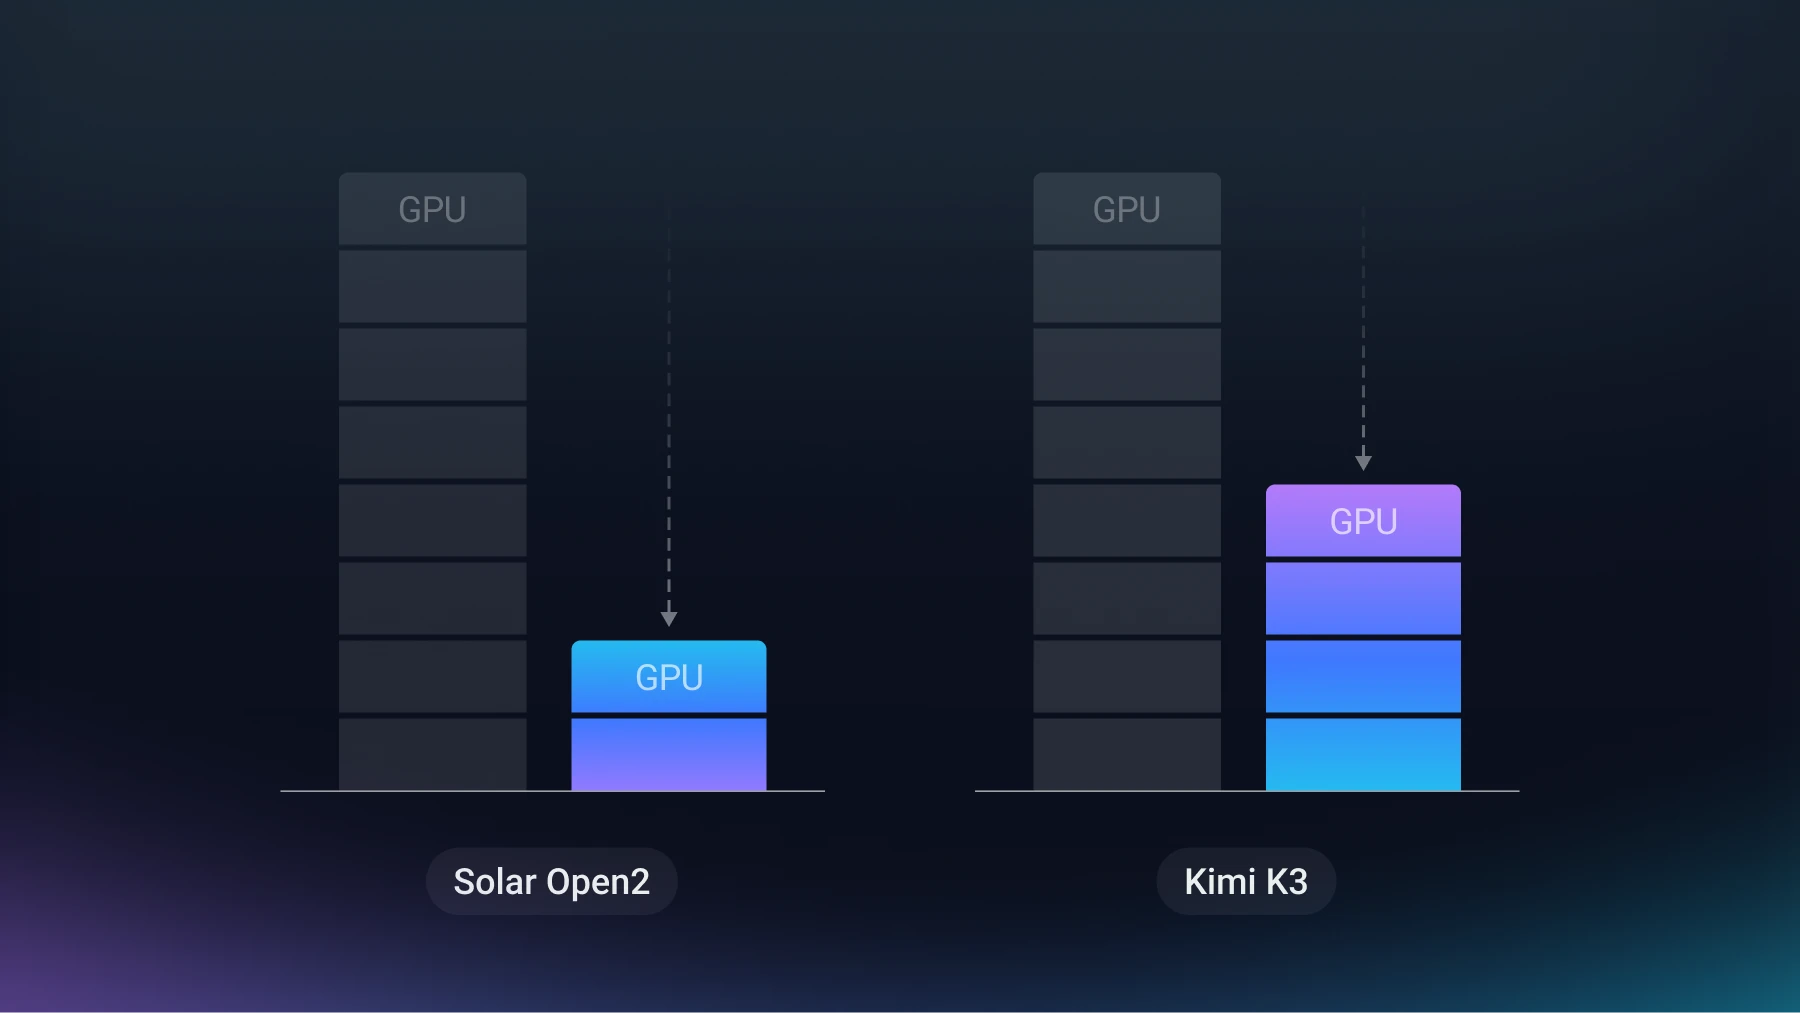
실제 사례도 있어요. 노타가 업스테이지의 솔라 오픈2(Solar Open2, 파라미터 2,500억 개) 모델을 4비트로 양자화했을 때 가중치가 500.6GB에서 142.9GB로 줄면서, H100 GPU 8장이 필요하던 모델이 4장에서 돌아가게 됐어요. 이렇게 양자화는 무엇보다 메모리를 줄여 주고, 그 포맷을 지원하는 칩에서는 계산이 빨라지고 전력이 줄어드는 효과도 기대할 수 있어요.
물론 이렇게 가벼워지는 게 공짜는 아니에요. 몸무게 평균이 '거의' 같다고 했던 것처럼, 모델의 답도 완전히 똑같지는 않아요. 숫자를 덜 정밀하게 표현하는 만큼 모델의 성능은 조금 떨어질 수 있어요. 얼마나 떨어지는지는 모델과 작업에 따라 다른데, 적절한 수준으로 양자화하면 성능 저하가 크지 않은 경우도 많아요. 앞의 솔라 오픈2는 에이전트·수학·코드·한국어 등 15개 시험의 평균 점수가 양자화 전후로 81.57점에서 81.17점으로 0.40점 내려가는 데 그쳤고, 15개 중 4개는 오히려 점수가 올랐어요.
여기까지 보면 양자화가 꽤 간단해 보일 수 있는데요, 실제로는 그렇게 만만하지 않아요. 성능이 얼마나 떨어지는지가 눈금의 범위를 어떻게 정하느냐에 크게 달려 있거든요. 예를 들어 양자화할 숫자들 사이에 유난히 큰 값(이상치)이 하나 섞여 있다고 해 볼게요. 눈금 개수는 비트 수로 정해져 있기 때문에, 이 큰 값까지 담으려면 제한된 눈금을 더 넓은 범위에 나눠 써야 해요. 그러면 나머지 작은 숫자들은 성긴 눈금에 맞춰지면서 원래 값과의 차이가 훨씬 커질 수 있죠.
실제로 노타가 LG AI연구원의 K-EXAONE(파라미터 2,360억 개)을 NVFP4로 양자화할 때도, 일부 레이어에 이런 큰 값이 몰려 있었어요. 그래서 노타는 계산 결과는 그대로 두면서 숫자들을 섞어, 큰 값 하나에 몰려 있던 크기를 여러 숫자에 나눠 담았어요. 튀어나온 값이 줄어드니 눈금을 다시 촘촘하게 쓸 수 있었고, 그 결과 원본과 같은 수준의 정확도를 지켰어요.
여기까지 잘 따라오신 분들을 위해 마지막으로 하나만 더 알려 드릴게요. 양자화할 때는 숫자를 눈금에 맞춰 적기 전에, 눈금의 범위부터 정해야 해요. 가중치는 이미 정해진 숫자라 범위를 바로 알 수 있지만, 모델이 답을 만드는 동안 새로 생기는 중간 계산값, 즉 활성값은 입력에 따라 범위가 달라져 미리 정확히 알기 어려워요.
그래서 모델에 예시 데이터를 조금 넣어 보고, 활성값이 어느 범위에 얼마나 퍼져 있는지 먼저 살펴봐요. 이 과정을 캘리브레이션(보정)이라고 해요. 캘리브레이션에 사용하는 데이터가 실제 사용 환경과 너무 다르면 눈금의 범위를 잘못 정하게 되고, 그만큼 양자화 오차도 커질 수 있어요.
양자화(量子化)는 영어 quantization을 옮긴 말이에요. '양자(量子)'는 더 쪼갤 수 없는 기본 단위를 뜻하고, 양자화는 이어진 값을 그 기본 단위의 몇 배인지로 나타낸다는 뜻이에요. 이 글로 바꿔 말하면 기본 단위는 눈금 간격, 몇 배인지는 몇 번째 눈금인지예요. 물리학에서 에너지가 띄엄띄엄한 값만 가진다는 걸 양자화라고 부르는 것도 같은 뜻이에요.
둘 다 모델을 가볍게 만드는 경량화 기법이에요. 양자화는 숫자 개수는 그대로 두고 숫자 하나를 적는 비트를 줄여요. 가지치기(pruning)는 덜 중요한 숫자나 연결을 아예 빼서 숫자 개수를 줄여요. 사실 처음에 제가 오해했던 '잘라내서 작게 만드는 것'은 가지치기에 더 가까워요. 두 방법은 함께 쓰는 경우도 많아요. 나중에 가지치기도 공부해서 더 자세히 알려 드릴게요!
NVFP4는 NVIDIA가 최신 GPU(블랙웰 세대)용으로 만든 4비트 부동소수점 양자화 포맷이에요. 자에 비유하면, 숫자를 작은 묶음으로 나누고 묶음마다 눈금 간격을 따로 맞추는 방식이에요. 그래서 모든 숫자에 같은 자를 쓸 때보다 오차가 작아요. 이 세대 GPU부터 빠르게 계산할 수 있고, 그 이전 GPU에서는 속도 이득이 없어요.
W는 가중치(weight), A는 활성값(activation)의 비트 수예요. 수학 문제 풀이에 비유하면 가중치는 미리 외워 둔 공식이고, 활성값은 문제를 풀 때 연습장에 적는 중간 계산이에요. 가중치는 답을 만들 때 보통 바뀌지 않아서 배포 전에 미리 양자화해 둘 수 있어요. 활성값은 답을 만들 때마다 새로 생겨서 그때그때 처리해야 하니 더 까다로워요. 그래서 W4A16은 가중치만 4비트로 양자화하고, 활성값은 모델이 흔히 쓰는 16비트로 두는 방식이에요.