요즘 새로운 AI 모델이 나오면 소개 글에 숫자가 두 개씩 붙어 있곤 해요. 솔라 오픈2 모델 카드의 '총 파라미터'와 '활성 파라미터' 두 칸이 그래요.
파라미터가 모델의 크기를 나타낸다는 건 알겠는데 활성 파라미터라니? 처음엔 무슨 말인가 싶었어요.
힌트는 그 앞의 '구조' 칸에서 찾을 수 있었어요. 두 숫자는 MoE라는 모델 구조에서 나온 거예요(앞에 붙은 Hybrid-Attention은 이번 글에서 다루지 않아요). DeepSeek, Qwen, gpt-oss처럼 요즘 나오는 큰 모델 중 상당수가 이 구조를 쓰고 있어서 MoE를 알면 새 모델 소식이 훨씬 잘 읽힐 거예요. 그래서 이번엔 MoE를 제대로 공부해 왔어요.
MoE는 Mixture of Experts의 줄임말이에요. 우리말로 옮기면 '전문가 혼합'이라는 뜻인데요. 이름처럼 MoE는 AI 모델 안의 일부를 '전문가'라고 부르는 여러 부분으로 나누고, 들어온 글을 잘게 나눈 조각마다 그중 필요한 몇 개만 골라 일을 시키는 구조예요.
종합병원을 떠올리면 쉬워요. 장면 1은 접수처가 환자를 증상에 맞는 과로만 안내하는 모습이에요.
큰 병원에는 여러 과의 전문의가 있지만 환자 한 명이 모든 의사를 만나지는 않아요. 접수처가 증상을 듣고 맞는 과 한두 곳으로 안내해요. MoE도 똑같아요. 병원의 접수처 역할을 하는 라우터(router)가 들어온 토큰을 보고 어느 전문가에게 보낼지 정하고, 선택된 전문가들만 계산을 해요.
이제 도입부에서 봤던 솔라 오픈2 모델 카드 사양을 다시 살펴볼까요? 총 파라미터는 250B, 활성 파라미터는 15B였어요. 앞에서 공부한 내용에 대입해 보면, 출근한 전문의 전체가 250B이고 환자 한 명을 실제로 진료하는 전문의가 15B인 셈이에요.
이번에는 병원 대신 실제 모델이 어떻게 동작하는지 조금 더 자세히 살펴볼게요. 라우터는 토큰이 들어오면 전문가마다 이 토큰을 맡기면 좋을지 추천 점수를 매겨요. 그리고 점수가 높은 상위 몇 개 전문가만 실제로 계산하게 해요. 나머지 전문가는 이번 토큰은 맡지 않아요. 그림 1에서는 조각마다 색이 다른 선을 따라가면, 그 조각이 고른 전문가 2명이 보여요.
그림 1에서는 전문가 8명 중 2명이 일했지만 실제 큰 모델은 전문가를 수십~수백 개 두고 그중 몇 개만 골라 일하게 해요. 이때 토큰 하나에 전문가를 몇 개 고르도록 설계하느냐에 따라 활성 파라미터도 달라져요. 똑같이 총 파라미터가 250B인 모델이라도, 전문가를 더 많이 고르게 만들면 20B가 될 수도 있고, 더 적게 고르게 만들면 10B가 될 수도 있어요.
과거에는 대형 AI 모델 대부분이 MoE가 아닌 밀집(dense) 구조였어요. 밀집 구조는 토큰이 들어올 때마다 모델 전체가 다 같이 계산하는 방식이에요. 모델이 작을 때는 이 구조로도 큰 문제가 없었지만 더 똑똑한 모델을 만들려고 파라미터를 늘리면서 문제가 생겼어요. 파라미터가 늘어나는 만큼 계산도 함께 늘어나서, 토큰 하나를 처리할 때 꼭 필요하지 않은 부분까지 매번 계산하게 된 거예요. 그래서 지식은 늘리면서 계산은 늘리지 않는 방법이 필요했고, 그 결과 MoE 구조가 주목받게 됐어요.
장면 2는 장면 1의 병원이 밀집 모델처럼 돌아간다면 어떤 모습일지 그려 본 거예요.
밀집 모델에서는 토큰 하나가 모델 전체를 거쳐요. 병원으로 치면 배가 아파 온 환자도 내과, 외과, 안과를 차례로 모두 들러야 하는 셈이에요. 물론 안과에서 배 아픈 환자의 눈을 살펴보다가 뜻밖의 단서를 찾을 수도 있지만 사실 그런 일은 드물어요. 대부분은 내과만 가도 모든 과를 다 들른 것과 거의 같은 진단을 받을 수 있어요. MoE가 노리는 것도 이거예요. 토큰마다 맞는 전문가 몇 개만 계산하면서도 답의 품질은 크게 잃지 않는 거예요.
앞에서 본 것처럼 MoE의 가장 큰 장점은 계산에 드는 시간과 자원을 줄여 준다는 거예요. 다만 한 가지 기억해야 할 게 있어요. 진료하는 의사는 한두 명이어도, 어떤 환자가 올지 모르니 전문의는 모두 출근해 있어야 한다는 점이에요.
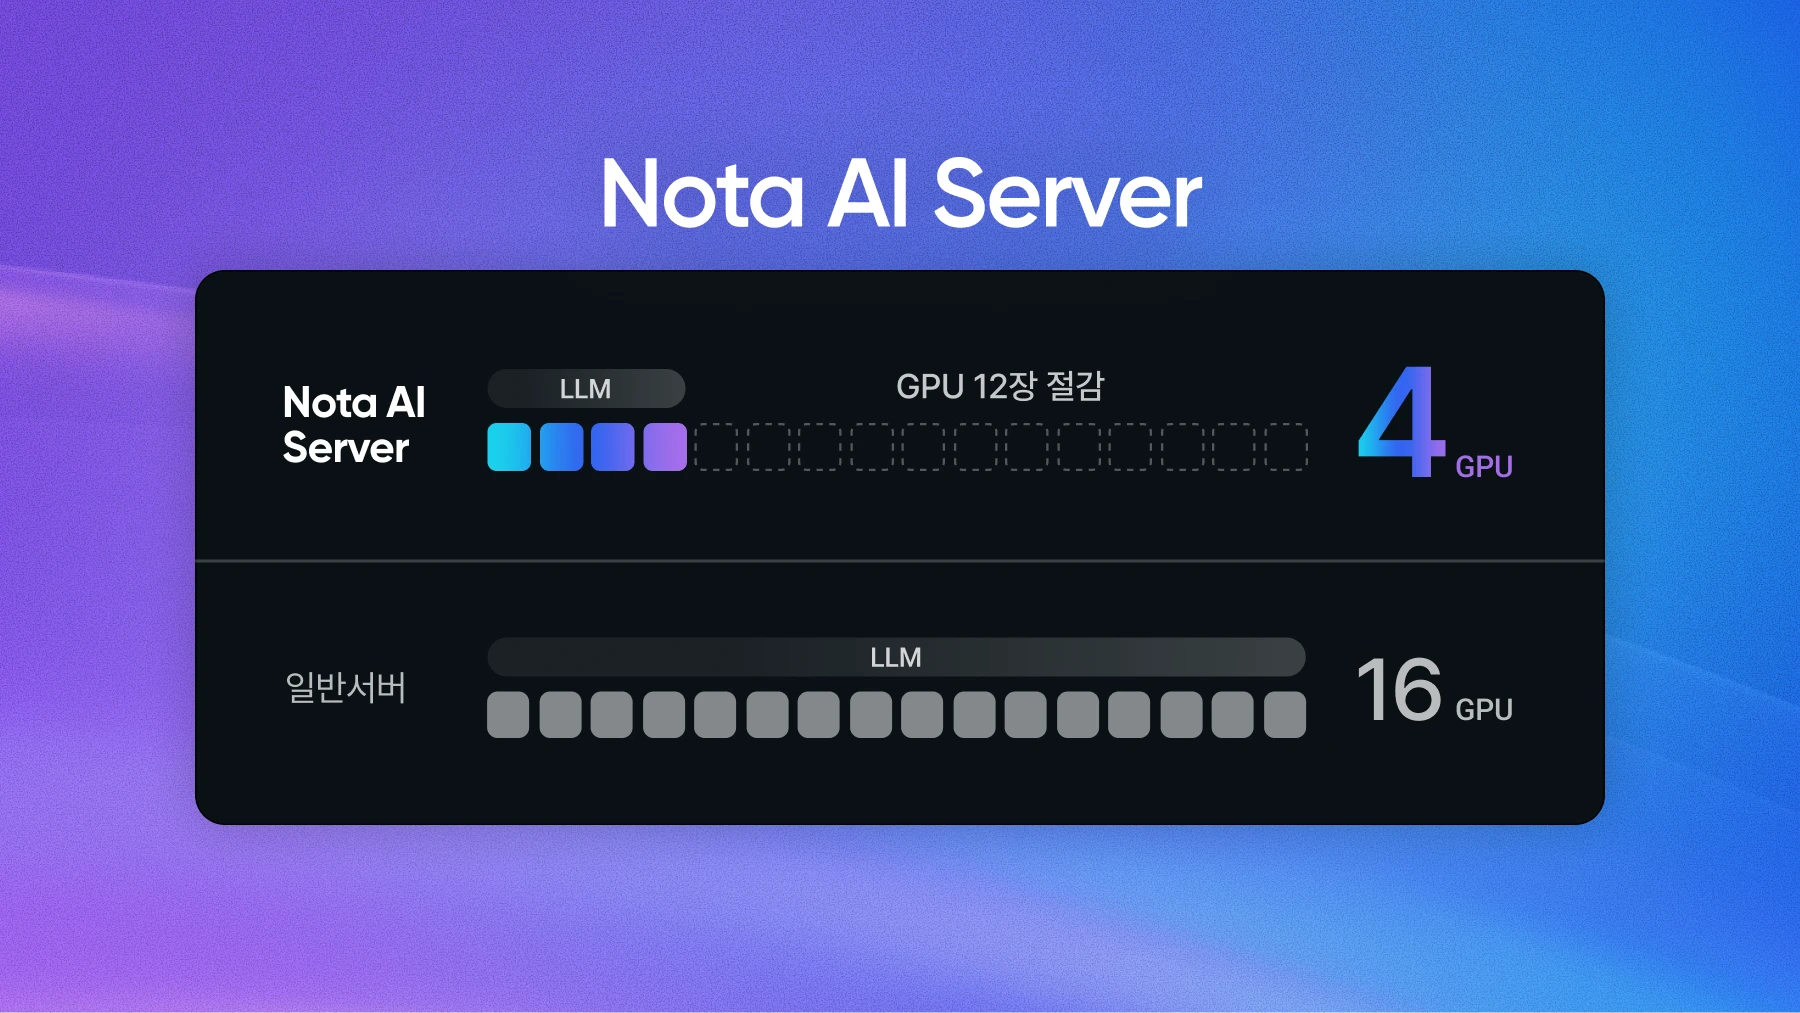
실제 MoE 모델도 마찬가지예요. AI 모델을 돌리려면 계산 말고도 파라미터를 올려 두는 공간인 메모리가 필요한데, 다음 토큰이 어떤 전문가를 부를지 미리 알 수 없으니 전문가 전원이 늘 메모리에 올라가 있어야 해요. 그래서 계산은 활성 파라미터만큼, 메모리는 총 파라미터만큼 필요해요. MoE 구조라고 해서 모델 전체 크기가 줄어드는 건 아니라는 뜻이에요. 솔라 오픈2를 원본 그대로 돌리려면 파라미터를 저장하는 데만 500.6GB가 들어서 AI용 GPU(H100)가 8장 필요해요.
지난번 양자화 해설에서 노타가 잘하는 일이 큰 모델을 성능은 지키면서 작게 만드는 양자화라고 말씀드렸는데요. MoE 모델도 전체 크기가 커서, 실제로 쓰려면 양자화로 작게 만들어야 하는 경우가 많아요. 그런데 MoE 모델은 일반 모델보다 양자화하기가 훨씬 까다로워요.
앞에서 MoE의 접수처 역할을 하는 게 뭐였는지 기억나세요? 바로 라우터예요. 라우터는 토큰마다 맞는 전문가를 잘 골라 줘야 해요. 그런데 양자화로 모델 속 숫자가 조금씩 덜 정확해지면, 라우터가 매기는 추천 점수도 원래와 조금씩 달라져요. 그러면 원래와 다른 전문가를 고를 수 있어요. 병원으로 치면 몸을 가볍게 하려고 다이어트를 한 접수처 직원이 기운이 빠져, 내과로 보내야 할 배 아픈 환자를 외과로 보내는 셈이에요. 물론 외과 의사도 배 아픈 환자를 어느 정도는 볼 수 있겠지만 내과 의사만큼 잘 보기는 어려울 거예요.
MoE 모델 양자화가 어려운 이유는 하나 더 있어요. 양자화하기 전에는 예시 데이터를 넣어 보면서 모델 속 숫자들이 어느 범위에 있는지 재는 캘리브레이션을 거치는데 평범한 데이터만 넣으면 일부 전문가는 거의 불리지 않아요.
말이 조금 어려웠는데요. 다시 병원으로 비유해 보면, 감기 환자는 많아서 내과 전문의는 자주 불리지만 맹장이 터진 환자는 드물어서 맹장 수술을 하는 외과 전문의는 거의 불리지 않아요. 이렇게 거의 불리지 않은 전문의는 어떻게 일하는지 잴 수가 없으니 양자화한 뒤에 정작 맹장 환자가 오면 제대로 진료하기 어려워요.
이렇게 MoE를 양자화할 때는 라우터가 원래와 같은 전문가를 고르도록 지키고, 거의 불리지 않는 전문가까지 제대로 재는 게 핵심이에요. 노타는 이 두 문제를 이렇게 풀고 있어요.
그리고 이 두 가지 방법을 함께 쓴 사례가 글 처음에 소개한 솔라 오픈2예요. 양자화에 가지치기(덜 중요한 부분을 덜어내는 기법)까지 더해 원본 500.6GB를 117.8GB로 줄였고, 그 덕분에 H100 8장이 필요하던 모델을 2장으로 돌릴 수 있게 됐어요. 고난도 추론 과제 점수도 원래의 99% 이상을 유지했어요(평균 83.99점 → 83.39점).
숫자 두 개로 시작했는데 라우터부터 메모리, 양자화까지 생각보다 알아야 할 게 많았어요. 그래도 이것만 기억하면 돼요. 계산은 고른 전문가만큼, 메모리는 전문가 전원만큼! 그리고 이 복잡한 MoE를 작게 줄이면서도 성능은 거의 그대로 유지해 주는 곳이 바로 노타라는 사실도요!
아니요, MoE는 모델을 처음 만들 때 정하는 설계 방식이에요. 모델을 가볍게 만드는 압축 기술은 양자화나 가지치기예요. 오히려 MoE 모델은 총 파라미터가 커서 메모리를 많이 쓰기 때문에, 실제로 돌릴 때는 압축이 더 필요한 경우가 많아요.
꼭 그렇지는 않아요. 전문가가 어떤 일을 맡을지는 사람이 정해 주는 게 아니라 모델이 학습하면서 저절로 나뉘어요. 그래서 '수학 담당', '코딩 담당'처럼 딱 떨어지기보다, 비슷한 모양의 단어나 문장 구조처럼 사람이 이름 붙이기 어려운 기준으로 나뉘는 경우가 많아요. 종합병원 비유의 내과·외과는 '맡는 일이 나뉜다'는 점을 보여 주려고 든 예예요.
모델마다 달라요. 믹스트랄(Mixtral 8x7B)은 전문가 8개 중 2개, gpt-oss-120b는 128개 중 4개, Qwen3-235B는 128개 중 8개, DeepSeek-V3는 256개 중 8개를 골라요. 전문가 수가 많아질수록 고르는 비율은 더 작아지는 경향이 있어요.
계산이 줄어드는 만큼 빨라지긴 하지만 딱 그 비율만큼 빨라지지는 않아요. 전문가 전원을 메모리에 올려 두고 필요한 전문가의 파라미터를 그때그때 꺼내 써야 하고, GPU 여러 장에 나눠 담으면 GPU끼리 데이터를 주고받는 시간도 들거든요.
달라요. 앙상블은 따로 만든 완성된 모델 여러 개에게 같은 문제를 전부 풀게 하고 답을 모으는 방식이라, 모델 수만큼 계산이 늘어나요. MoE는 모델 하나 안의 일부를 전문가로 나누고 그중 몇 개만 풀게 해서, 계산이 크게 늘지 않아요.
장점은 지식의 양(총 파라미터)을 크게 늘려도 토큰 하나를 처리하는 계산은 작게 유지할 수 있다는 거예요. 단점은 전문가 전원을 메모리에 올려 둬야 해서 메모리가 많이 들고, 양자화로 크기를 줄일 때도 일반 모델보다 까다롭다는 점이에요.
함께 읽으면 좋은 글