현지 시각 10월 19일 오후 3시 15분, 산호세 The Tech Interactive에서 열린 Arm과 노타의 핸즈온 세션장이 개발자로 가득 찼습니다. 이날 참가자들은 얼리 액세스로 제공 중인 Arm AI Model Optimizer를 직접 다뤄 보았는데요. 각자 노트북으로 45분 핸즈온 동안 이미지 분류 모델을 Arm NPU(AI 연산 전용 프로세서)용으로 최적화하고 그 결과까지 확인했습니다. 명령어 몇 개와 설정 파일로 정리된 작업 흐름 덕분에, 모델 최적화가 낯선 개발자도 모두 끝까지 과제를 마쳤습니다.
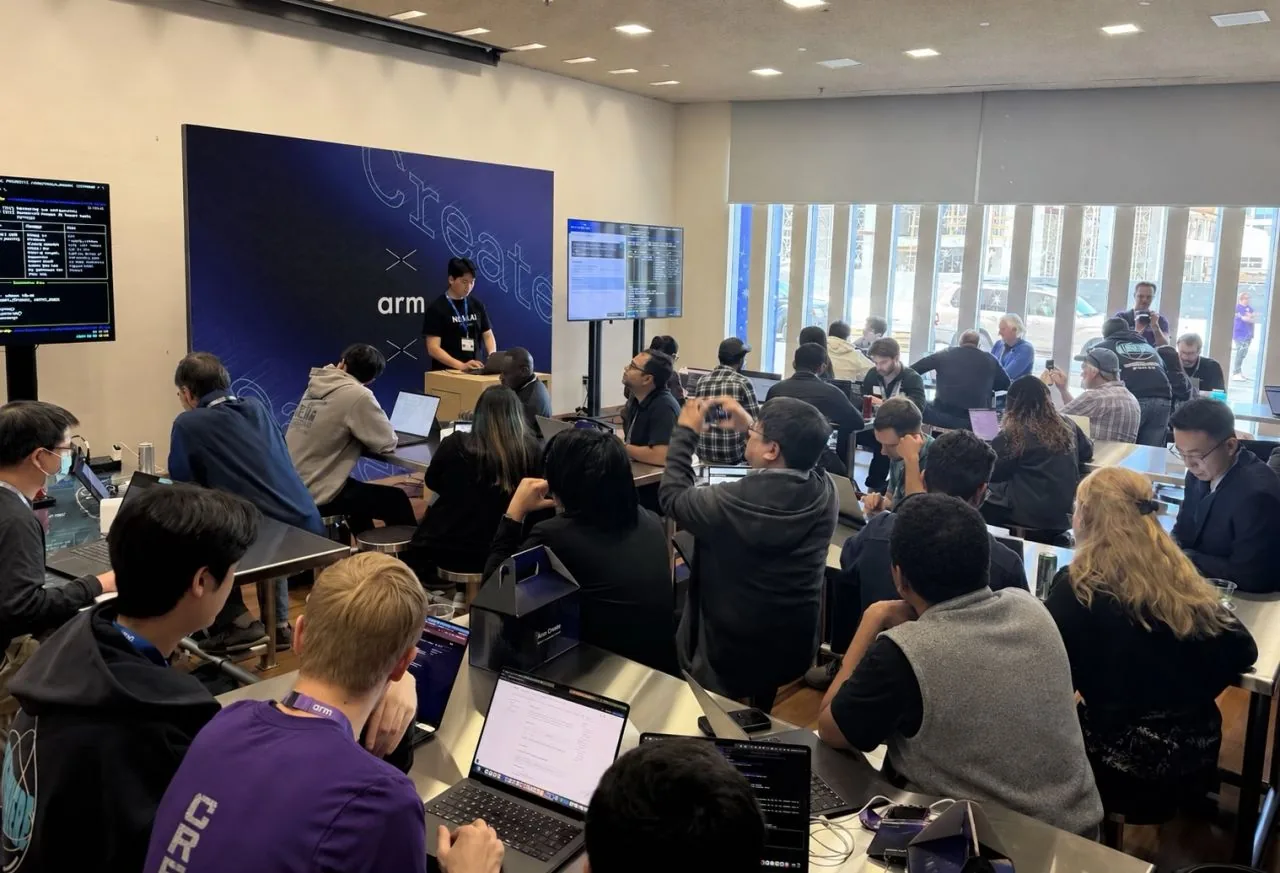
Arm Create는 PyTorch Conference 주간에 맞춰 열린 개발자 행사입니다. 클라우드부터 엣지, 피지컬 AI에 이르기까지 Arm 기반 하드웨어에서 AI를 구현하고 최적화해 보는 핸즈온 중심의 자리였는데요. 참가자들은 Gemma·LiteRT·PyTorch·ExecuTorch 등을 다루는 세션에 자유롭게 참여하며 관심 있는 기술을 체험해 볼 수 있었어요.
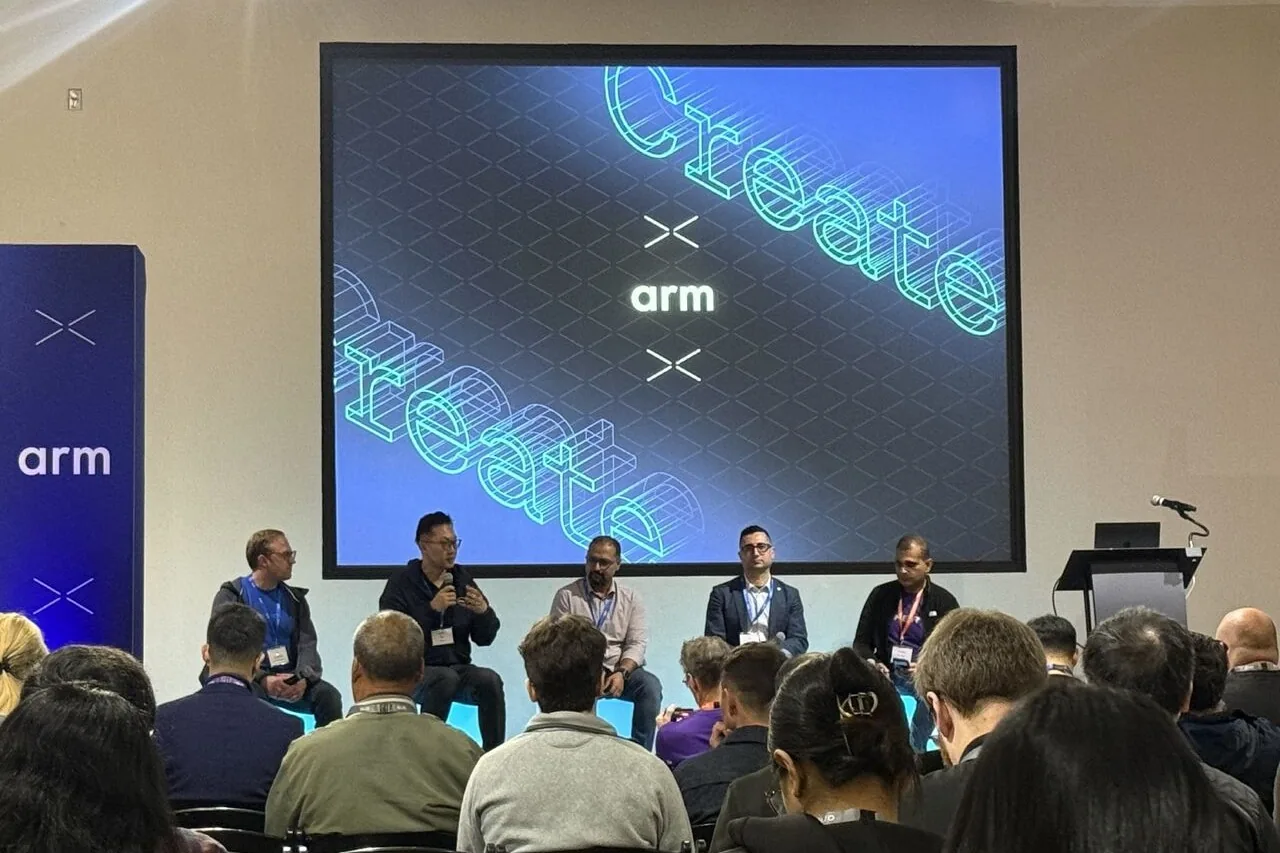
행사 파트너로는 Google, Renesas, 노타 세 곳이 참여했고, 오프닝 패널에도 세 파트너사와 Arm의 연사들이 함께했습니다. 노타에서는 미국 법인(Nota AI America)의 Steven Kim 대표가 참여하여 급변하는 AI 환경에서 개발자들이 마주하는 과제와 기회에 대해 이야기를 나눴습니다. 특히 모델 발전 속도가 빨라질수록 효율적인 AI 애플리케이션을 만들기 위한 하드웨어와 소프트웨어 최적화가 더욱 중요해질 것이라는 인사이트를 강조하기도 했습니다.
이날 행사는 노타에게 더욱 특별한 의미가 있었습니다. 노타의 기술이 담긴 Arm AI Model Optimizer를 외부 개발자들이 직접 다뤄 보는 핸즈온 세션을 Arm과 함께 진행했기 때문입니다. 이날 Arm은 Arm AI Portal의 새로운 도구인 Arm AI Model Optimizer의 얼리 액세스 프로그램도 함께 소개했어요.
Arm AI Model Optimizer는 노타의 넷츠프레소(NetsPresso®) 기술을 기반으로 구축한 모델 최적화 도구입니다. 그래프 최적화, 양자화, 혼합 정밀도를 적용하고, 최적화 전후의 성능·정확도·메모리를 비교해 각자의 애플리케이션에 맞는 설정을 선택할 수 있도록 돕는데요. 현재 얼리 액세스로 제공되고 있으며, 도구에 대한 자세한 소개는 Arm 블로그에서 확인하실 수 있어요.
이 도구를 활용해 실제로 모델을 최적화한 대표 사례들을 살펴보면 다음과 같습니다.
세 사례는 모델 종류도, 기기도 모두 다릅니다. 음성 인식 모델은 스마트폰에서, 이미지 분할·분류 모델은 Raspberry Pi 5에서 최적화했는데, 세 경우 모두 정확도는 거의 그대로 두고 처리 속도를 높였어요. 이 과정을 행사 현장에서 참가자들이 직접 따라가 본 것이 노타의 핸즈온 세션이었습니다.
노타는 "Hands-on AI model optimization for Arm" 세션에 주어진 90분을 세 부분으로 나눠 썼습니다. 도구 소개 40분, 핸즈온 45분, 마무리 5분입니다.
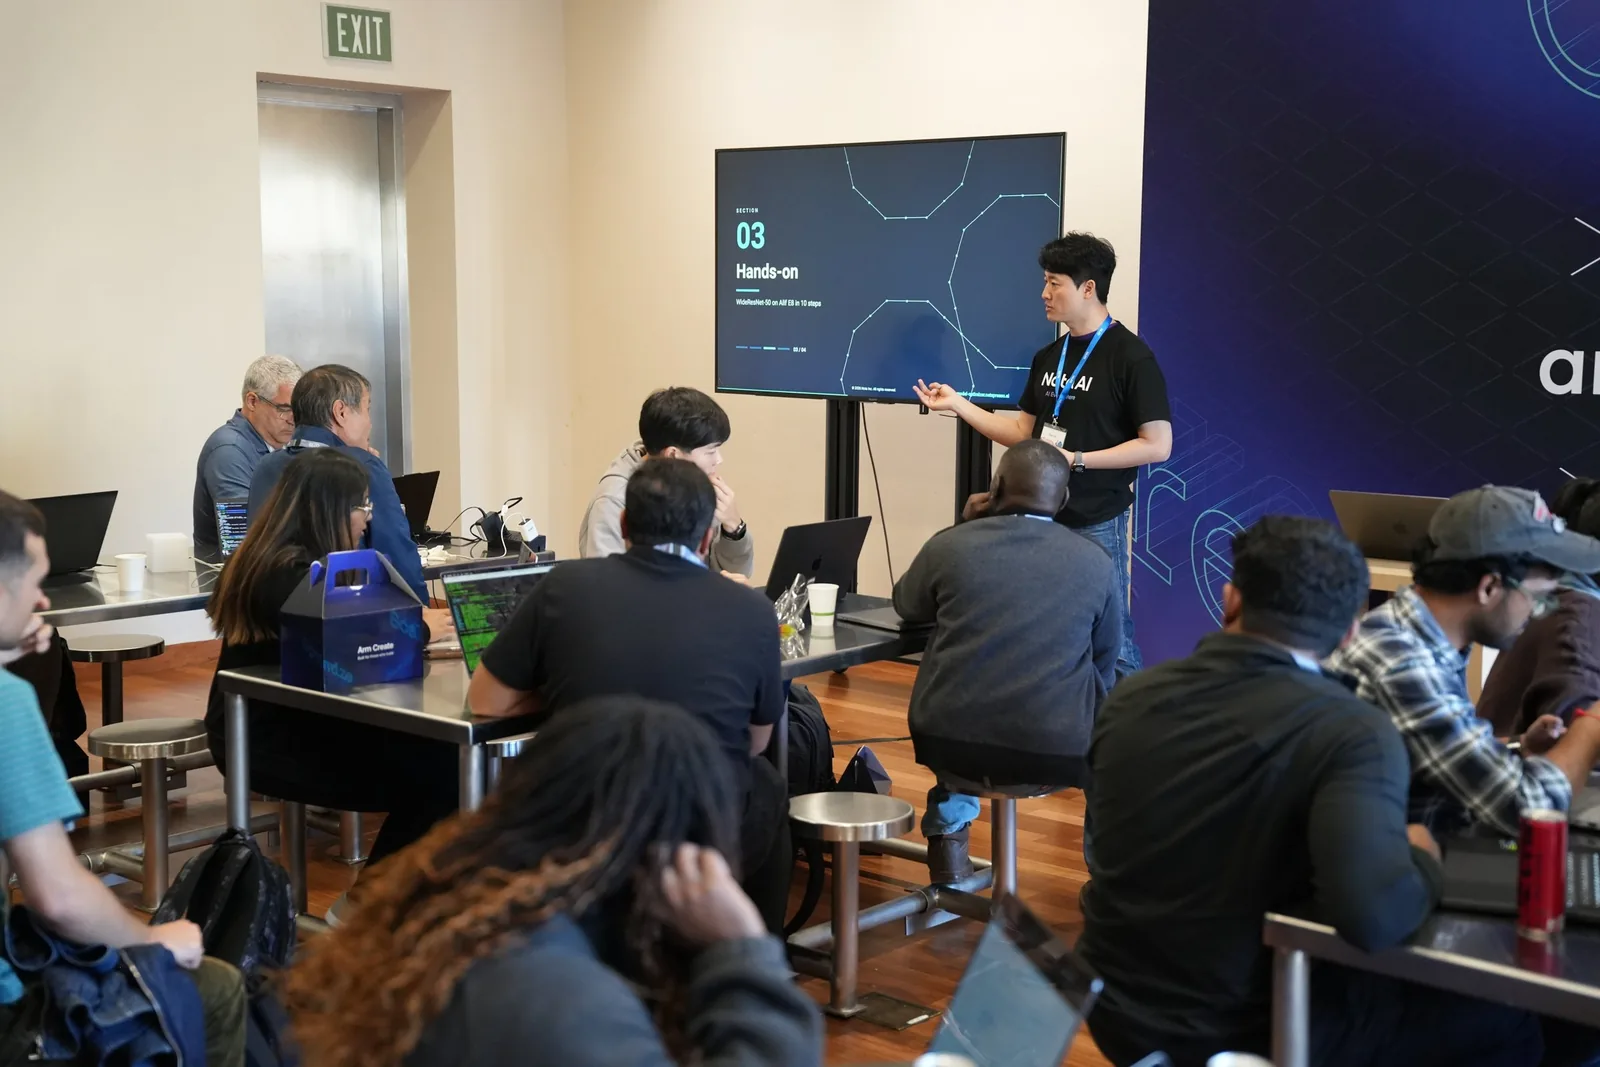
첫 40분 동안 김태호 CTO는 왜 이 도구가 필요한지, 그리고 구체적으로 어떻게 활용하는지를 설명했습니다. 새로운 모델 구조는 매년 빠르게 쏟아져 나오지만, 칩이 지원하는 하드웨어 연산은 출하 시점에 이미 정해져 있어서, 최신 모델을 기존 칩에서 원활하게 구동하려면 최적화가 필수적이라는 이야기로 시작했습니다. 이어서 CLI로 실험을 만들고, 실행하고, 결과를 비교하는 사용 흐름을 차례로 보여 줬습니다.
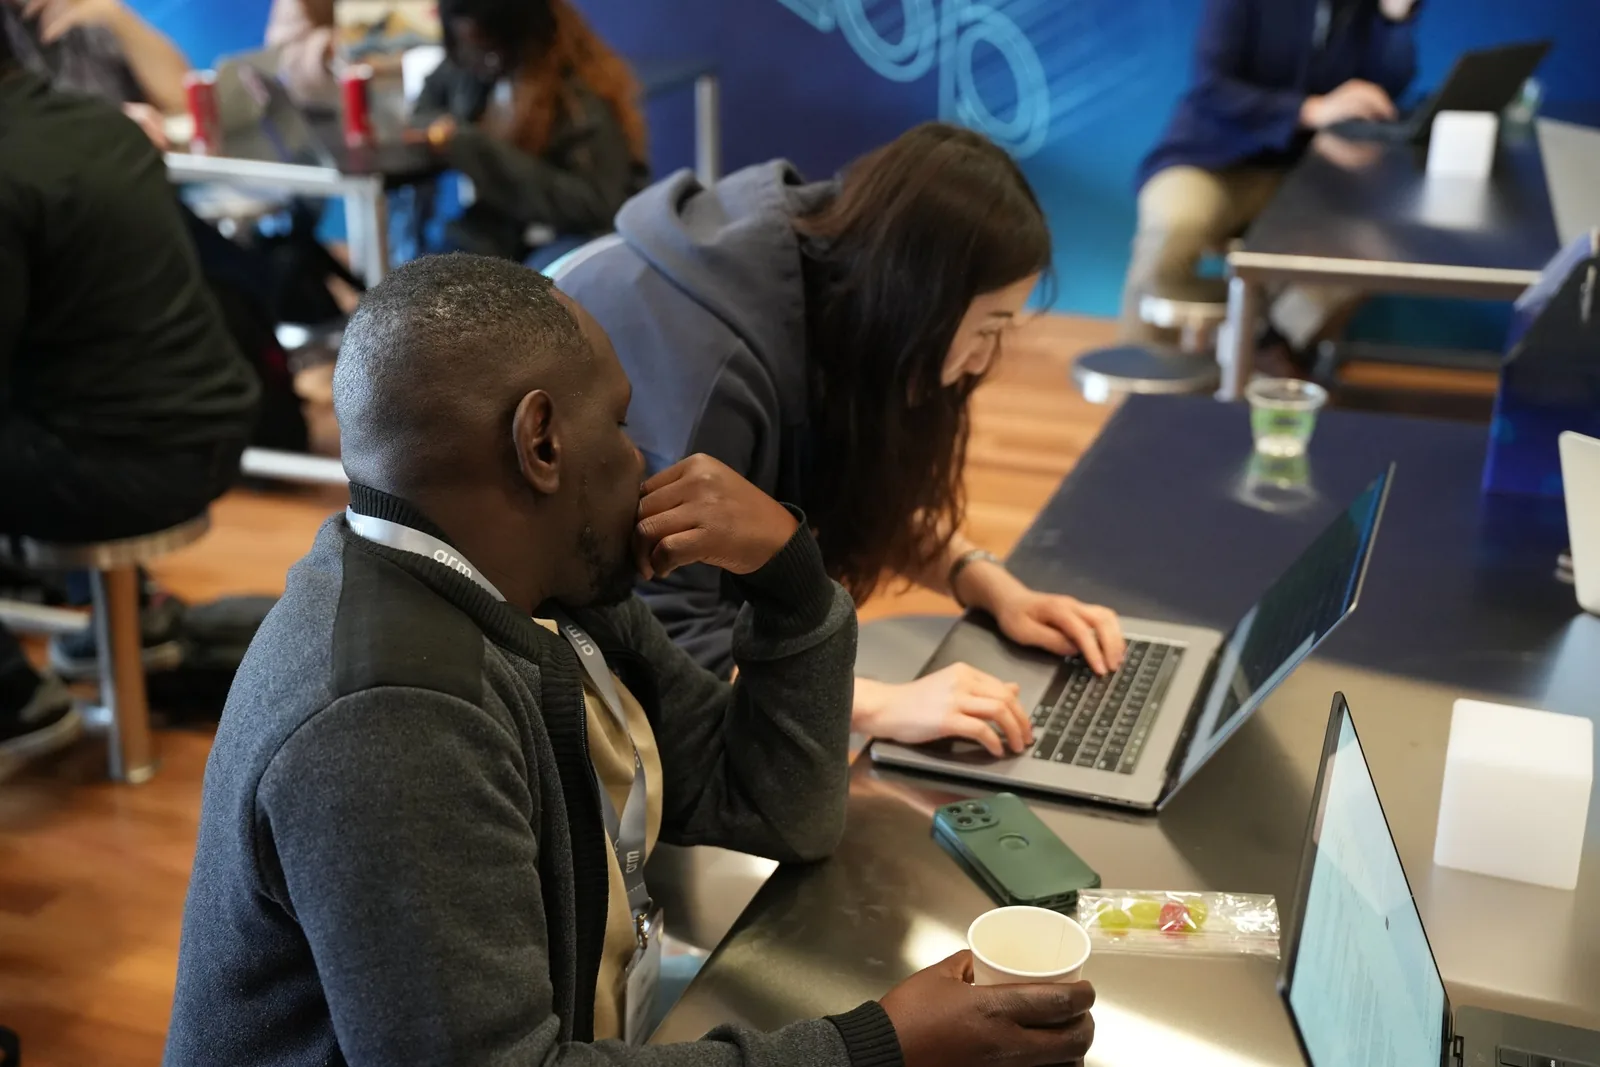
이어진 45분 동안 참가자들은 튜토리얼을 따라 명령어를 하나씩 입력하며 각자 노트북으로 최적화 작업을 제출하고 결과를 확인했어요. 노타 팀원들은 테이블 사이를 돌며 진행을 도왔고, 막히는 부분이 생기면 그 자리에서 함께 해결했어요.
마지막 5분은 미리 준비해 둔 LLM 최적화 결과를 공개하는 데 썼습니다. 핸즈온 과제는 엣지 NPU 타깃의 이미지 분류 모델이었지만, 같은 도구로 클라우드 CPU에서 돌아가는 LLM도 최적화할 수 있다는 걸 보여 주려는 순서였어요. LLM은 이미지 분류 모델보다 규모가 커서, 세션이 끝나기 전에 결과를 함께 볼 수 있도록 시작할 때 작업을 서버에 먼저 제출해 두었어요.
45분 동안 참가자들이 수행한 핸즈온 과제와 그 결과를 살펴볼게요.
핸즈온은 Arm AI Model Optimizer를 실제로 쓰는 과정을 그대로 따라가도록 구성했습니다. 과제는 그림 1에도 나온 이미지 분류 모델 WideResNet-50을 Alif Ensemble E8 DevKit에 맞게 최적화하는 것이었어요. 이 보드에는 Cortex-M55 CPU와 Arm의 NPU인 Ethos-U85가 들어 있고, 최적화는 그래프 최적화와 INT8 양자화(모델의 숫자를 8비트 정수로 줄이는 과정) 두 단계를 차례로 거칩니다. 참가자들은 튜토리얼을 따라 CLI 설치부터 실험 생성, 실행, 리포트 확인, 그래프 시각화, .pte 파일(기기에서 실행하는 모델 파일) 추출까지 10단계를 진행했습니다.
실행 전에 바꾼 설정은 다음과 같아요.
세부 설정 파일(run.detail.yaml)에서 Ethos-U85에서의 실행 속도를 높이기 위해 가중치 granularity를 채널 단위(CHANNEL)에서 텐서 단위(TENSOR)로 바꾸고, 정확도를 지키기 위해 활성화 보정 방식을 PERCENTILE에서 HISTOGRAM으로 수정했습니다. HISTOGRAM은 값의 분포를 보고 양자화 오차가 가장 작은 범위를 자동으로 골라 주는 방식이에요. 값을 고친 뒤에는 np validate 명령어로 설정이 올바른지 바로 확인할 수 있었어요. 실행이 끝나면 np report 명령어 한 번으로 원본 모델과 단계별 최적화 결과를 나란히 비교해 볼 수 있어요.
한 번의 실행으로 지연 시간은 26.6% 줄었고, Top-1 정확도는 원본 모델과 0.5%p 차이로 유지됐습니다. 정확도는 거의 같고, 한 번 추론하는 데 걸리는 시간은 4분의 1가량 줄어든 결과예요. 최적화한 모델의 파일 크기는 42.71MB로, Ethos-U85에서 실행할 수 있는 .pte 파일로 추출됐습니다. 지연 시간은 실제 보드 없이 Arm MLIA로 추정한 값이에요. 그림 1의 WideResNet-50과는 기기와 평가 데이터가 달라서 정확도 수치가 다르게 나와요.
그림 3에서 그래프 최적화 단계의 수치가 원본과 같은 건, 이 단계가 대상 하드웨어에 맞게 연산 구조를 정리하는 준비 단계이기 때문이에요. 지연 시간과 정확도의 변화는 다음 단계인 양자화에서 나타나요.
도구 없이 같은 결과를 얻으려면 여러 단계를 따로 거쳐야 해요. 모델을 ExecuTorch(PyTorch 모델을 기기에서 실행하는 런타임) 형식으로 내보내고, 양자화 세부 설정과 캘리브레이션 데이터를 직접 구성한 뒤, Vela 컴파일러(Ethos-U NPU용 컴파일러)로 컴파일해요. 그다음 지연 시간 추정과 정확도 평가를 각각 돌려 결과를 비교해야 하고요. 단계마다 쓰는 도구와 설정이 달라 하나씩 맞춰야 하는데, 참가자들은 이 과정을 명령어 몇 개와 설정 파일 하나로 마쳤습니다.
세션 초반에 제출해 둔 작업은 Qwen2.5-0.5B-Instruct를 Arm 기반 클라우드 CPU인 AWS Graviton4에 맞게 최적화하는 것이었습니다. 모델과 하드웨어는 달라도, 프로젝트를 만들고 실행한 뒤 리포트로 비교하는 순서는 핸즈온 과제와 같았어요. 런타임은 ExecuTorch, 백엔드는 XNNPACK(CPU 연산 가속 라이브러리)이었고, 이미지 분류 과제와 달리 그래프 최적화와 양자화 앞에 AWQ 양자화 단계를 하나 더 거쳤습니다. 중요한 가중치를 지키면서 양자화해 LLM의 정확도 손실을 줄이는 단계예요.
최적화 결과 모델 파일 크기는 39.0% 줄었고, XNNPACK으로 처리하는 연산 비율은 38.0%에서 54.5%로 늘었습니다. 더 많은 연산을 CPU 가속 경로로 처리하게 됐다는 뜻이에요. 그러면서도 정확도(OpenBookQA 기준)는 원본과 0.2%p 차이로 유지됐습니다.
마지막으로 응답 속도를 확인했어요. 원본 모델과 최적화한 모델에 같은 질문 7개를 넣자, 이 데모에서 질문 평균으로 최적화한 모델이 원본보다 첫 토큰은 1.8배, 응답 전체 생성은 2.3배 빨랐습니다.
이번 핸즈온에는 과제를 마친 뒤 다른 모델로 자유롭게 테스트해 볼 수 있는 단계도 마련돼 있었어요. 기본 과제에 그치지 않고 Raspberry Pi 5에서 ResNet-18을 최적화하거나, Graviton4에서 Qwen2.5를 직접 돌려 본 참가자도 있었습니다.
핸즈온이 이어지는 동안 테이블마다 지원되는 AI 모델과 하드웨어의 범위부터 최적화 전후 성능 비교, 기존 개발 과정에 적용하는 방법, 자체 환경에서 평가하는 방법까지 질문이 오갔습니다. "과연 될까?"가 아니라 "내 프로젝트에는 어떻게 적용할 수 있을까?"를 고민하는 실무적인 질문들이었습니다. 최적화를 직접 해 보는 데 큰 어려움이 없었기에, 참가자들의 관심도 자연스럽게 실제 적용이라는 다음 단계로 이어질 수 있었습니다.
Arm AI Portal에서는 Arm 디바이스에 최적화된 모델을 바로 가져다 쓸 수 있습니다. 원하는 조건에 맞는 모델이 없다면, Arm AI Model Optimizer를 이용해 같은 작업 흐름 안에서 직접 최적화하면 됩니다.
이번 세션에서는 프리셋 모델과 데이터를 썼지만, 직접 준비한 데이터를 등록해 평가해 볼 수도 있어요. 데이터는 이미지, 음성, 텍스트 등 다양한 형식으로 보정용과 평가용을 나눠 등록할 수 있습니다. 모델은 프리셋 외에도 Qwen, Gemma, Llama 같은 Hugging Face의 LLM을 불러와 최적화할 수 있습니다.
Arm AI Model Optimizer는 현재 약 50종의 프리셋 모델을 제공합니다. 평가 기준 기기는 Alif Ensemble E8·Raspberry Pi 5·MacBook M4·vivo X300 Pro·AWS Graviton4 다섯 종입니다. 설치부터 첫 프로젝트까지 시작하는 방법은 퀵스타트 문서에서 단계별로 확인할 수 있어요.
이번 핸즈온은 참가자들이 엣지 NPU부터 클라우드 CPU까지 모델 최적화를 하나의 도구로 해 본 시간이었습니다. Arm과 노타는 앞으로 런타임·백엔드·지원 하드웨어를 늘려 가고, 얼리 액세스 프로그램 참가자들의 의견을 바탕으로 기능과 사용성을 계속 개선할 계획입니다.
세션에서 다룬 과정을 직접 해 보고 싶다면, Arm AI Portal에서 Early Access Program을 신청해 보세요.