LLM 양자화에서 실용적인 한계선은 흔히 4비트로 꼽힙니다. 비트를 그보다 더 낮추면 용량은 줄어들지만 답변 품질이 크게 떨어지기 때문입니다. 로컬 LLM에서는 이 제약이 더 까다롭습니다.
복잡한 코딩이나 여러 단계로 이어지는 작업을 맡기려면 보통 27B~30B급 모델부터 쓸 만하다고 봅니다. 그런데 30B 모델은 4비트로 줄여도 가중치만 16GB 안팎입니다. 런타임 메모리와 KV 캐시까지 더하면 16GB 기기에는 올라가지 않고, 24GB 맥북에서도 빠듯합니다.
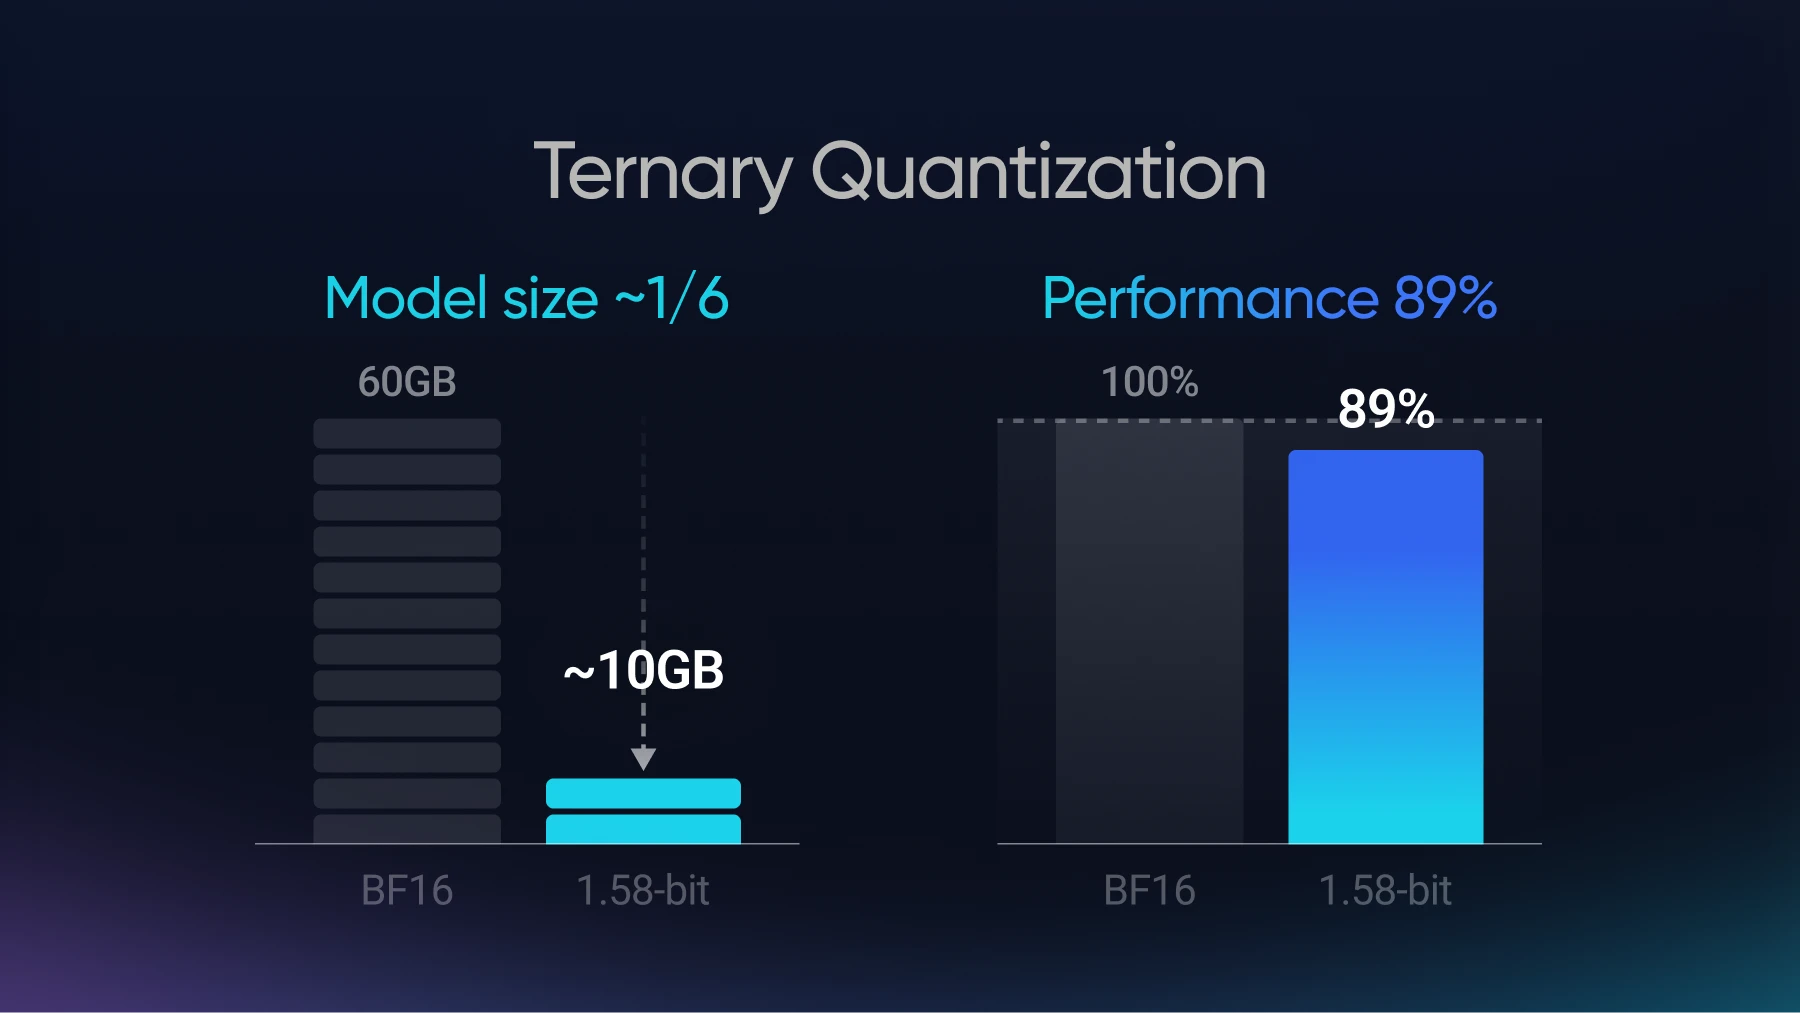
그래서 노타는 30B라는 모델 크기는 그대로 두고, 비트를 4비트 아래로 낮췄습니다. NVIDIA가 공개한 Nemotron 3.5 Lightning 30B(A3B)의 가중치를 -1, 0, +1 세 값으로만 표현하는 1.58비트 양자화입니다. 모델 용량은 약 10GB로 줄었고, 성능은 생성형 벤치마크 평균 기준 원본의 89% 수준까지 복원했습니다. 이 글은 그 과정을 정리합니다.
1.58비트 양자화는 LLM의 가중치를 -1, 0, +1 세 값으로만 표현하는 터너리(ternary) 양자화입니다. 세 값을 구분하는 데 필요한 이론적 최소 비트 수가 log₂3 ≈ 1.585비트이기 때문에 1.58비트라고 부릅니다. 여기서 1.58비트는 디스크에 저장되는 파일 크기가 아니라 값 하나가 담는 정보량을 뜻합니다. 실제 파일에는 가중치 외에 스케일 값(scale factor)이 함께 저장되므로 파라미터당 비트 수는 이보다 커집니다.
터너리로 바꾸면 가중치 행렬의 각 칸은 크기와 부호에 따라 -1, 0, +1 가운데 하나가 됩니다. 0에 가까운 작은 값은 0이 되고, 나머지는 부호만 남습니다.
1.58비트 모델을 만드는 경로는 크게 두 가지입니다.
노타는 이번에 PTQ 방식을 택했습니다. 사전학습을 처음부터 다시 하지 않고, 이미 학습된 모델을 그대로 활용할 수 있기 때문입니다.
터너리 양자화는 세 단계로 이루어집니다. 결국 정해야 하는 것은 두 가지로, 어느 크기 이하의 가중치를 0으로 볼지(임계값 τ)와 남은 가중치를 어떤 크기로 되돌릴지(스케일 s)입니다. 아래 그림은 단계별 핵심 수식을 정리한 것입니다.
이해를 돕기 위해 가중치 8개로 이루어진 예시 그룹으로 계산을 따라가 보겠습니다. 이 그룹의 α는 0.39, 임계값 τ는 0.195, 복원 스케일 s는 0.58입니다. 아래 그림에서 각 가중치가 터너리 코드와 복원값으로 바뀌는 과정을 볼 수 있습니다.
이때 중요한 것은 0이 되는 가중치의 비율입니다. 0이 너무 적으면 0에 가까운 작은 값까지 ±1로 커져 복원 오차가 늘어나고, 너무 많으면 남는 정보가 줄어 모델의 표현력이 떨어집니다. 이 비율은 임계값 τ가 정하며, 예시 그룹에서는 8개 중 3개가 0이 됐습니다.
위 절차대로 진행한 PTQ는 무사히 끝났습니다. 그러나 자체 평가에서 GSM8K와 HumanEval은 0.00, 한국어 지시 이행을 평가하는 IFEval-ko는 10.36이 나왔습니다.
직접적인 원인은 반올림 오차입니다. 앞의 예시에서 0.90이 복원 뒤 0.58로 바뀌는 것처럼, 가중치마다 복원 오차가 생기고 이 오차가 층을 거치며 누적됩니다. 트랜스포머처럼 수십 개 층을 쌓아 다음 토큰을 예측하는 구조에서는 층별 오차가 최종 출력 확률에 반영되고, 토큰을 하나씩 생성해 채점하는 생성형 벤치마크에서는 정답을 거의 맞히지 못하는 결과로 나타납니다.
사실 이는 2비트 이하의 극단적 저비트 양자화에서 흔히 발생하는 현상입니다. 도입에서 4비트를 LLM 양자화의 실용적인 한계선으로 소개한 것도 같은 맥락입니다. 비트 수를 줄여 파일을 작게 만드는 것과 모델의 능력을 유지하는 것은 별개의 문제이고, 비트 수가 낮을수록 그 차이가 커집니다.
그렇다면 0점이 된 모델은 어떻게 되돌릴 수 있을까요? 노타는 두 단계로 접근했습니다.
첫 번째 기법은 증류(distillation)입니다. 보통은 교사 모델이 미리 생성한 답변을 학생이 따라가는 off-policy distillation을 많이 사용합니다. 다만 이 방식만으로는 학생이 양자화 때문에 실제로 만들어내는 출력이 학습 신호에 거의 반영되지 않고, 양자화 뒤 출력 분포가 크게 달라진 터너리 모델에서는 이 차이가 더 커집니다. 그래서 이번에는 off-policy distillation에 on-policy distillation을 함께 적용했습니다.
여기서 on-policy는 학생이 직접 만든 문맥을 바탕으로 배운다는 뜻입니다. 학생(터너리 모델)이 답변 토큰을 생성하면, BF16 교사가 같은 문맥에서 다음 토큰의 확률 분포를 계산합니다. 학생은 교사의 분포와 자기 분포의 차이를 학습 신호로 받습니다. 비유하면 학생이 쓴 풀이를 선생님이 한 줄씩 따라가며, 줄마다 "나라면 다음에 이렇게 썼을 것"을 알려 주는 방식입니다. on-policy를 함께 적용한 것도 양자화로 달라진 출력 분포를 교사 쪽으로 다시 맞추기 위해서입니다.
남은 문제는 양자화된 가중치를 미분할 수 없다는 점입니다. 이를 위해 STE(Straight-Through Estimator)를 씁니다. 순전파(forward pass)에서는 터너리 코드를 그대로 쓰고, 역전파(backward pass)에서는 양자화 함수를 항등 함수(identity function)로 간주해 기울기를 잠재 가중치에 전달합니다. 잠재 가중치는 터너리 코드 뒤에 실수로 남겨 둔 값으로, 작은 업데이트가 쌓이면서 조금씩 바뀌다가, 임계값 τ를 넘는 순간 양자화된 코드가 바뀝니다.
이 구조 때문에 1에폭(학습 데이터 전체를 한 번 학습하는 단위) 동안 실제로 코드가 바뀐 가중치는 전체의 약 5~7%였습니다. 복원은 모델에 새 지식을 넣는 작업이 아니라, 양자화로 바뀐 소수의 코드를 원본 출력에 맞게 고치는 작업에 가깝다는 뜻입니다. 실제로 복원한 모델에 한국어로 자기소개를 요청하면, 모델은 자신을 NVIDIA 연구진이 만든 Nemotron이라고 답합니다. 복원 과정에서 원본 모델의 정체성이 그대로 유지됐다는 간접 신호입니다.
증류와 STE만으로도 1~2에폭 사이에서는 성능이 크게 올라옵니다. 1에폭과 2에폭을 거치며 GSM8K는 82.56, 87.57, HumanEval은 72.56, 80.49, IFEval-ko는 61.79, 68.39까지 올랐습니다.
하지만 에폭을 늘리는 것만으로는 성능이 계속 오르지 않았습니다. 같은 조건에서 3에폭까지 학습하자 GSM8K는 85.90, IFEval-ko는 64.82로 다시 내려갔습니다. 모델을 바꿔 실험해도 같은 패턴이 나타났습니다. STE가 모든 잠재 가중치에 신호를 전달하면서, 바뀔 필요가 없는 값까지 계속 갱신되어 노이즈로 코드가 바뀌는 것으로 보였습니다. 그래서 학습할 가중치의 범위를 좁혀 보았습니다.
PTQ 초기값이 임계값 τ의 ±10% 범위 안에 있는 가중치, 즉 전체의 약 5.9%만 학습하고 나머지 잠재 가중치는 동결했습니다. 경계 근처로 좁힌 것은 그 범위의 가중치만 작은 업데이트로 코드가 실제로 바뀔 수 있기 때문입니다. 경계에서 먼 값은 학습해도 코드가 바뀌기 어렵고, 노이즈만 더할 수 있습니다. 이 방식을 경계 마스킹이라고 부릅니다.
같은 3에폭에서 경계 마스킹을 적용하면 GSM8K는 85.90에서 88.32로, IFEval-ko는 64.82에서 68.39로 다시 올라옵니다. 학습을 더 오래 하는 것보다 어디를 학습할지 정하는 쪽이 효과가 컸다는 뜻입니다.
복원을 마친 모델은 생성형 벤치마크 7종 평균에서 원본 93.80점 대비 83.82점, 원본의 89.4%를 기록했습니다. 사후 변환 직후 0.00점이었던 GSM8K도 89.31점으로, 원본의 94% 수준까지 회복했습니다.
벤치마크별로 보면 수학(GSM8K)과 코드(HumanEval)는 원본의 94% 수준을 기록했고, 7종 중 5종은 원본의 89% 이상이었습니다. 회복률이 상대적으로 낮은 항목은 풀이가 긴 MATH500과 한국어 지시 이행(IFEval-ko)으로, 앞으로 더 개선할 부분입니다.
그렇다면 몇 GB 맥북이면 이 모델을 돌릴 수 있을까요? 맥에서는 통합 메모리 전체를 GPU가 쓰지 않고, 기본 설정에서는 대략 2/3~3/4까지만 씁니다. 보수적으로 2/3로 계산하면 16GB 맥북의 GPU 한도는 약 10.7GB, 24GB 맥북은 약 16GB입니다.
이 모델의 가중치는 약 10GB이지만, 실행하려면 KV 캐시와 Mamba 상태, 런타임 버퍼가 더 필요합니다. Nemotron 3.5 Lightning은 Mamba 층과 Attention 층을 함께 쓰는 하이브리드 구조로, KV 캐시가 필요한 Attention 층은 6개라서 128K 토큰 문맥에서도 KV 캐시가 약 0.8GB를 차지합니다. 공개 설정 파일로 계산하면 가중치 외 메모리는 최대 약 2.4GB, 전체는 최대 약 12.4GB입니다. 16GB 맥북의 한도보다는 크고, 24GB 맥북의 한도보다는 작습니다.
16GB 맥북도 macOS 설정으로 GPU 메모리 한도를 높이면 계산상 들어가지만, 그만큼 시스템과 다른 앱이 쓸 메모리가 크게 줄어듭니다. 그래서 24GB 이상 맥북을 권장합니다.
이 모델은 Hugging Face에 공개돼 있어, 아래 저장소에서 받아 직접 실행해 볼 수 있습니다. 현재 공개한 모델은 성능 복원을 이어 가고 있는 프리뷰 체크포인트이며, 모델 카드에 저장 포맷과 평가 조건이 함께 정리돼 있습니다.