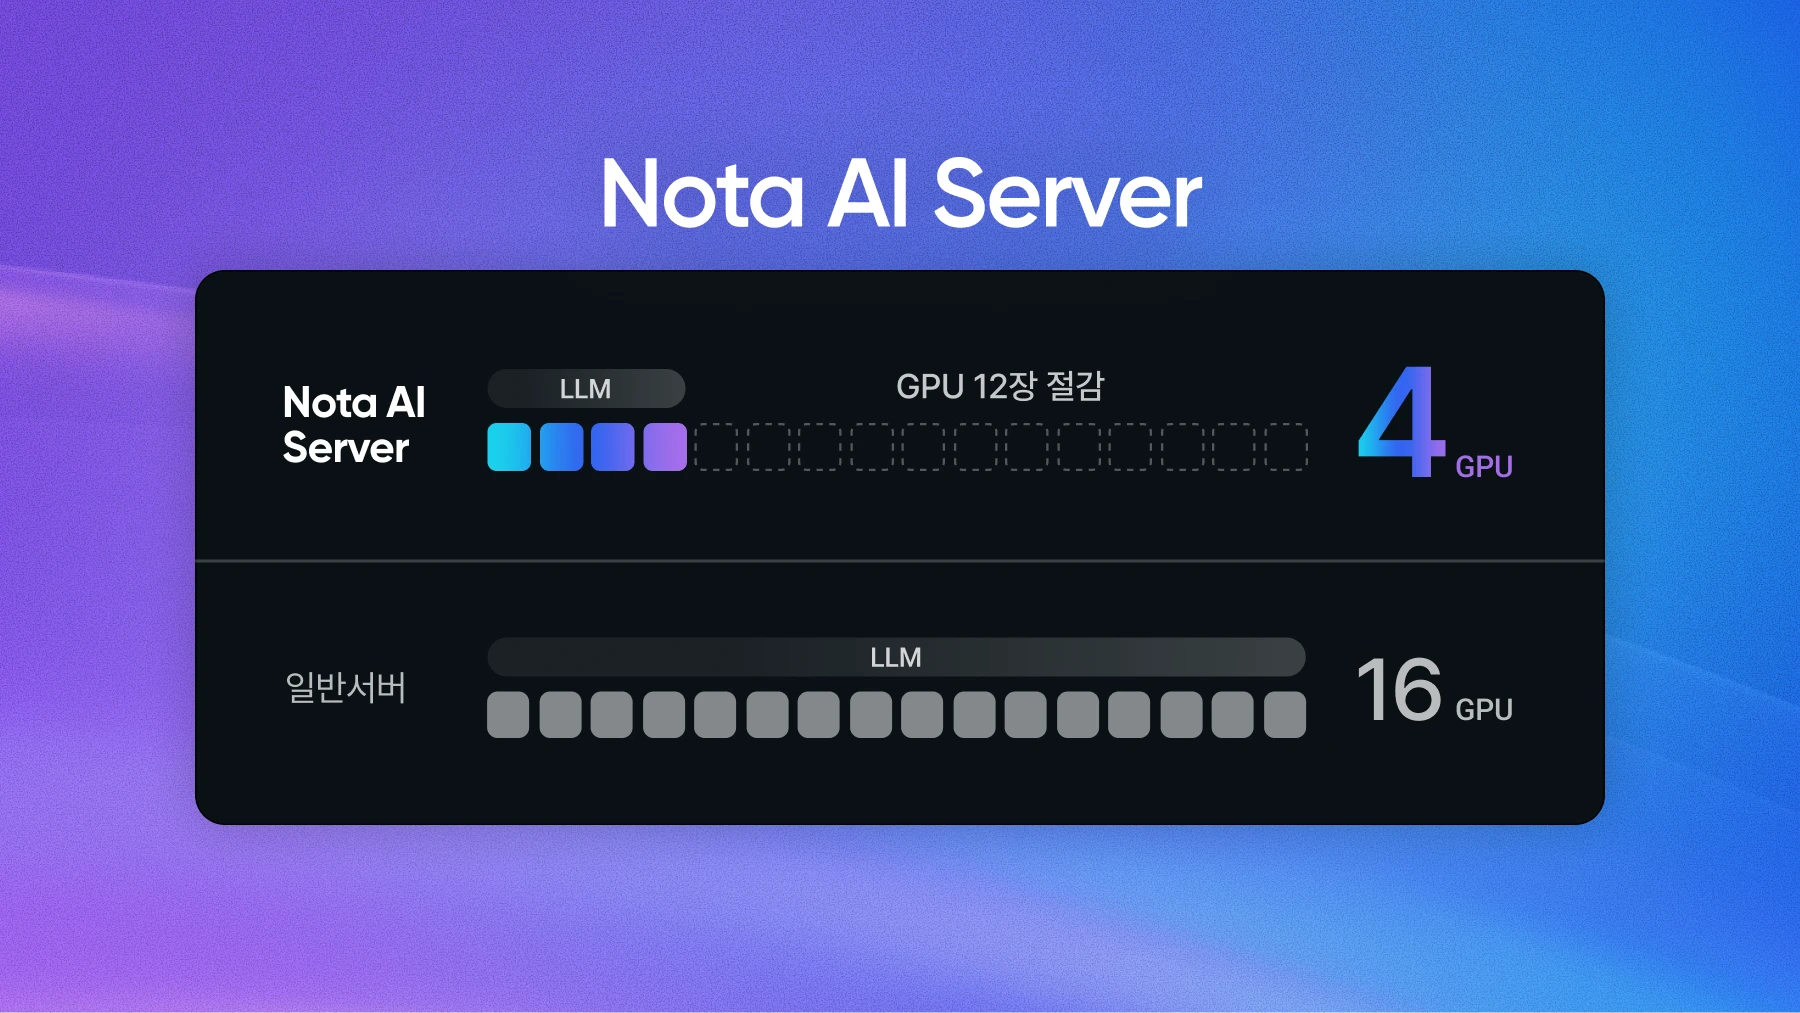
사내 AI 에이전트를 온프레미스 LLM으로 운영하려 할 때 가장 큰 고민은 GPU 비용입니다. GPU는 한 장에 수천만 원에 이르기도 하고, 한 번 들여온 서버는 구성을 바꾸기 어렵습니다. GPU가 모자라면 추가로 사야 하고, 남으면 쓰지 않는 장비에 예산이 묶입니다. 가격이 내려가기를 기다리기도 어렵습니다. 블룸버그 보도에 따르면, NVIDIA는 메모리 비용 상승을 이유로 2027년 초 출하하는 서버 가격을 15% 이상 올릴 계획입니다. GPU를 몇 장 살지 구매 전에 정확히 따져 봐야 하는 이유입니다.
금융권·공공기관처럼 보안이나 규제 때문에 클라우드 API를 쓸 수 없는 조직은 Private AI를 직접 구축해야 합니다. AI 워크로드를 온프레미스로 옮긴 기업에 이유를 물은 설문에서도 보안·거버넌스(42%)를 꼽은 응답이 비용 절감(25%)보다 많았습니다. 이런 조직이라면, GPU를 사기 전에 확인할 것이 있습니다.
GPU 구성은 스스로 판단해야 하지만, 쉽지 않습니다. GPU 서버 공급사와 함께 구성을 검토하기도 하는데, 하드웨어 상담만으로는 답을 내기 어렵습니다. 필요한 GPU 수는 모델을 얼마나 최적화할 수 있는지에 따라 달라지기 때문입니다. GPU 수는 모델과 대화 문맥(KV 캐시)이 차지하는 메모리 총량에 따라 정해지는데, 이 총량은 정확도를 유지하면서 모델을 어디까지 줄일 수 있느냐에 따라 차이가 큽니다. 원본 모델 크기만 보고 GPU 수를 정하면 양자화(quantization)와 가지치기(pruning)로 줄일 수 있는 몫이 빠지고, 서버를 들여온 뒤에도 모델 최적화와 서빙 구성을 맡을 인력이 필요합니다.
Nota AI Server는 조직이 쓰려는 모델을 GPU 구성에 맞춰 최적화하고, 서빙까지 구성한 상태로 제공하는 온프레미스 LLM 서버입니다. 20명이 각자 128K 문맥으로 동시에 쓰는 조건에서, 원본 정밀도로는 GPU 16장이 필요한 250B급 모델을 4장으로 운영합니다. 같은 서비스를 4분의 1의 GPU로 운영할 수 있고, 줄어드는 GPU 12장만큼 장비 비용과 전력, 상면 공간도 함께 줄어듭니다. 이 글에서는 온프레미스 LLM을 구축할 때 GPU 구성을 어떻게 정해야 하는지, Nota AI Server를 쓰면 무엇이 달라지는지 살펴봅니다.
온프레미스 LLM은 서버를 사서 모델을 올리는 것으로 끝나는 일이 아닙니다. 먼저 GPU를 몇 장 살지 정해야 하는데, 이때 정확히 잡기 어려운 것이 두 가지입니다. 최적화로 줄일 수 있는 메모리와, 실제 사용 조건에 따라 늘어나는 메모리입니다.
흔히 쓰는 산정 방식은 파라미터 수에 정밀도별 바이트 수를 곱하고, 대화 문맥을 저장하는 KV 캐시와 여유분을 더하는 계산입니다. 이때 정밀도를 어디까지 낮출 수 있는지에 따라 GPU 수가 크게 달라집니다. 같은 모델도 BF16에서 4비트로 내리면 가중치 메모리가 4분의 1로 줄어듭니다. 하지만 양자화나 가지치기를 적용한 뒤에도 정확도가 유지되는지는 해당 모델로 직접 검증해야 알 수 있고, 검증하려면 GPU와 평가 작업이 먼저 필요합니다. 그래서 구매 단계에서는 원본 정밀도(BF16)나 FP8처럼 정확도 걱정이 적은 기준으로 잡는 경우가 많고, 최적화로 줄일 수 있는 메모리는 산정에서 빠집니다.
사용 조건에 따라 늘어나는 메모리는 모델 구조마다 따로 계산해야 합니다. 동시 사용자가 늘고 한 번에 다루는 문맥이 길어질수록 KV 캐시가 커지는데, 그 크기는 모델마다 크게 다릅니다. 동시 사용자 20명이 각자 128K 토큰 문맥을 쓰는 조건에서 Qwen3.6-27B는 4비트로 양자화한 모델이 16~19GB인데, KV 캐시에는 약 80GB가 필요합니다. KV 캐시는 모델 전체 크기가 아니라 어텐션 층의 구조에 따라 정해지기 때문에, 같은 조건에서도 13.5GB(Gemma 4 26B-A4B)에서 240GB(Solar Open 100B)까지 차이가 납니다. Solar Open 100B는 4비트로 양자화하면 GPU 한 장에 들어가지만, 이 KV 캐시 때문에 GPU 4장으로 구성합니다. GPU 수가 모델 크기보다 사용 조건에 따라 정해지는 경우입니다.
최적화를 적용하면 필요한 메모리가 줄고, 동시 사용자와 문맥이 늘면 필요한 메모리가 늘어납니다. 그래서 GPU 수는 최적화를 어디까지 적용할 수 있는지와 실제 사용 조건을 함께 계산해야 정해집니다. Nota AI Server는 대상 모델의 최적화와 정확도 검증을 GPU 구매 전에 마치고, 그 결과를 기준으로 GPU 수를 정합니다. 그렇다면 최적화를 먼저 적용하면 GPU는 얼마나 줄어들까요?
Nota AI Server는 정확도 손실을 대부분 1% 미만으로 유지하면서 VRAM을 최대 73.5%(Solar Open 2, KV 캐시 포함 기준) 절감합니다. 적용 기법은 4비트 양자화(INT4·NVFP4)이고, 일부 모델은 Global Pruning(전역 가지치기)을 함께 적용합니다. 이 기법들은 노타가 ICML 2026 워크숍에서 발표한 전문가 혼합 구조(MoE) 양자화 연구(DREAM-MoE, SRA-MoE)를 바탕으로 합니다. MoE 모델은 라우터(router)가 입력마다 일부 전문가를 골라 계산하므로, 양자화 오차로 라우터의 선택이 바뀌면 정확도가 떨어집니다. 노타는 원본 모델이 매기던 전문가 순위가 유지되도록 양자화 파라미터와 라우터를 함께 캘리브레이션하고, 자주 쓰이지 않는 전문가까지 고르게 캘리브레이션되도록 데이터를 구성합니다.
대표 사례는 250B급 Solar Open 2(활성 15B MoE)입니다. 이 모델은 Global Pruning과 4비트 양자화를 함께 적용해 RTX PRO 6000 16장이 필요한 구성을 4장으로 줄였습니다. 모델 가중치만 보면 500.6GB에서 117.8GB(INT4 기준)로, H100 8장이 필요하던 모델을 2장에 올릴 수 있는 크기입니다.
정확도 차이는 작습니다. 4비트 양자화만 적용했을 때 15개 벤치마크 평균은 원본(BF16) 81.57에서 81.17로 0.40점 낮아졌습니다. 가지치기에서는 어떤 전문가를 남길지가 정확도를 좌우합니다. MoE 모델은 층마다 중복된 전문가의 비율이 다르기 때문에, 모든 층에서 같은 비율로 지우면 민감한 층까지 손상됩니다. Global Pruning은 네트워크 전체에서 전문가의 중요도를 비교해 층마다 남길 전문가 수를 다르게 정합니다. 그 결과 Global Pruning까지 적용한 모델도 고난도 추론 벤치마크 3종 평균이 83.39로 양자화만 적용한 모델(83.99)과 비슷했고, 같은 비율로 균일하게 전문가를 제거하는 REAP 방식(78.79)보다 높았습니다. 가지치기까지 더해도 정확도는 크게 달라지지 않는 셈입니다. 양자화 모델과 Global Pruning 모델 모두 Hugging Face에 공개되어 있습니다.
처리 속도도 함께 높아졌습니다. Hugging Face에 공개한 측정에서 Global Pruning을 적용한 Solar Open 2(NVFP4)는 B300 4장 기준으로 원본 대비 토큰 처리량이 동시 사용자 1명일 때 1.23배, 32명일 때 1.49배였습니다. 토큰 하나를 생성하는 시간이 28.4ms에서 17.8ms로 줄어든 덕분입니다. 첫 토큰까지 걸리는 시간은 1명일 때 0.98초에서 0.74초로 줄었고, 32명일 때는 4.9초에서 5.3초로 비슷한 수준이었습니다. 모델을 줄여도 처리 속도는 떨어지지 않고, 동시 사용자가 많을수록 처리량 이득이 커진다는 뜻입니다.
줄인 GPU만큼 초기 투자를 아낄 수도 있고, 같은 GPU로 더 많은 사용자를 받거나 다른 모델을 함께 서빙할 수도 있습니다.
GPU 수를 줄이는 일은 모델을 작게 만드는 데서 끝나지 않습니다. 줄인 모델을 어떤 GPU에서, 어떤 방식으로 나눠 실행할지까지 함께 정해야 실제 구성이 나옵니다.
최적화의 목표는 메모리를 조금씩 줄이는 것이 아니라, 필요한 GPU 수가 한 단계 줄어드는 크기까지 줄이는 것입니다. 모델을 여러 GPU에 나눠 올리는 텐서 병렬(tensor parallelism)은 모델 구조에 맞춰 2장, 4장, 8장처럼 정해진 단위로만 GPU 수를 늘릴 수 있습니다. Solar Open 2를 INT4로 양자화한 모델은 KV 캐시까지 합치면 162.9GB로, H100 2장의 용량(160GB)을 2.9GB 넘깁니다. 3장으로는 나눌 수 없으므로 4장이 필요합니다. Global Pruning으로 137.8GB까지 줄이면 2장에 들어갑니다. 메모리 25GB 차이가 H100 2장 차이로 이어지는 셈입니다.
같은 4비트라도 형식에 따라 실행할 수 있는 GPU가 다릅니다. INT4(W4A16)는 가중치만 4비트로 줄이고 계산은 16비트로 하기 때문에 H100이나 L40S에서도 동작합니다. NVFP4(W4A4)는 활성값(activation)까지 4비트 부동소수점으로 계산해 처리 속도를 더 높일 수 있지만, Blackwell 세대 GPU(RTX PRO 6000, B300)의 FP4 연산 유닛이 있어야 실행됩니다. 그래서 표 2에서 L40S 구성은 INT4를 쓰고, Blackwell 구성은 모델에 따라 INT4와 NVFP4 중에서 고릅니다.
가지치기도 마찬가지입니다. Global Pruning을 적용하면 그림 4처럼 층마다 남은 전문가 수가 달라집니다. 조 단위 모델 Kimi K3에서 전문가의 50%를 제거한 모델은 92개 MoE 층마다 남은 전문가가 350개에서 717개까지 다릅니다. 기본 vLLM은 모든 층의 전문가 수가 같다고 가정하기 때문에 이 모델을 그대로 서빙하지 못합니다. 노타는 층별 전문가 수를 읽도록 수정한 vLLM 모델 정의를 함께 제공합니다. 전문가 수가 층마다 다르면 전문가를 GPU별로 나눠 맡기는 전문가 병렬(EP)도 쓸 수 없어서, 텐서 병렬로 구성을 다시 정합니다. 최적화한 모델 파일만으로는 기본 vLLM에서 서비스를 띄울 수 없고, 서빙 환경까지 함께 맞춰야 하는 이유입니다.
Nota AI Server는 앞에서 본 최적화와 서빙 구성을 마친 상태로 설치됩니다. 직접 구축한다면 GPU 서버를 들여온 뒤 모델을 양자화하고, 정확도를 검증하고, 모델에 맞는 서빙 엔진을 고르고, 여러 GPU에 병렬화를 설정하고, 동시 사용자 부하를 시험하는 일을 차례로 진행해야 합니다. 서빙을 전담할 인력이 없는 조직일수록 이 차이가 큽니다. 기본 구성은 다음과 같습니다.
모델은 4비트 양자화와 호환성 검증을 마친 상태로 들어가고, 서빙 엔진은 vLLM과 SGLang 중 해당 모델에 맞는 쪽으로 설정됩니다. 최적화된 모델이 GPU 한 장에 적재되면 GPU별로 독립 인스턴스 두 개를 띄워 처리량과 장애 격리를 확보하고, 한 장에 들어가지 않는 대형 모델에만 텐서 병렬(TP)을 적용합니다. 인증, 사용량 한도, 요청 큐, 모니터링·로그처럼 여러 부서가 함께 쓰는 데 필요한 운영 기능도 기본으로 들어 있습니다.
설치가 끝나면 128K 문맥에서 20명이 동시에 요청을 보내는 부하 검증을 포함한 인수 테스트를 거칩니다. 사내 시스템은 받은 날부터 OpenAI 호환 API 엔드포인트 하나만 호출하면 되고, OpenAI API 형식에 맞춰 만든 사내 도구라면 호출 주소를 바꾸는 것으로 연결할 수 있습니다. 사내 시스템 쪽에서 따로 개발할 일이 거의 없다는 뜻입니다. 폐쇄망 환경에는 Air-gap 패키징을 제공해, 외부 인터넷 연결 없이 설치하고 모델과 데이터를 사내 서버 안에서만 운영할 수 있습니다.
라인업은 모델 규모에 따라 Standard, Advanced, Premium 세 가지입니다. 파라미터 수백억 개 규모부터 조 단위 규모까지, L40S에서 B300까지 서로 다른 모델과 GPU의 조합을 한 라인업으로 낼 수 있는 것은, 노타가 엣지 디바이스부터 서버까지 여러 칩과 모델을 최적화해 온 경험이 있기 때문입니다. 모든 구성은 동시 사용자 20명·세션당 128K 조건을 기준으로 설계되었습니다.
같은 티어 안에서도 업무에 따라 맞는 모델이 다릅니다. 예를 들어 Standard에서 사용자가 많고 예산이 우선이면 L40S로 구성하는 Qwen3.6-35B-A3B, 계약서·스캔 문서처럼 문서 이해가 중요하면 Gemma 4 31B가 맞습니다. Solar Open 시리즈는 노타가 정부 소버린 AI 사업에서 공식 최적화한 모델입니다.
Premium은 앞에서 살펴본 Kimi K3를 Global Pruning으로 줄인 구성입니다. MoE 전문가의 50%를 제거해 B300 8장 구성을 4장으로 줄였고, 같은 50% 조건에서 Cerebras의 MoE 전문가 가지치기 방법인 REAP와 비교한 공개 벤치마크 4개 중 3개에서 더 높은 점수를 기록했습니다. 품질을 더 우선하는 조직을 위해 전문가의 25%만 제거해 B300 6장으로 구성하는 선택지도 제공합니다. 두 모델 모두 Hugging Face에 공개되어 있습니다.
라인업에 없는 모델이나 하드웨어도 PoC로 최적화 가능성과 예상 성과를 진단할 수 있습니다. 직접 고른 오픈소스 또는 자체 LLM·VLM, 표준 목록 밖의 NVIDIA GPU, NPU 같은 AI 가속기, 엣지 하드웨어, 기존 프라이빗 클라우드나 하이브리드 환경과의 통합까지 범위를 넓힐 수 있습니다. 최적화부터 PoC, 배포까지 노타가 함께 진행합니다.
보안이나 규제 때문에 클라우드 API를 쓸 수 없는 조직에게 GPU 구성은 한 번 정하면 되돌리기 어려운 결정입니다. GPU 수를 모델 크기만 보고 정하면 최적화로 줄일 수 있는 몫이 빠지고, 구매한 뒤에도 모델 최적화와 서빙 구성이 과제로 남습니다. Nota AI Server는 조직이 쓰려는 모델을 GPU 구성에 맞춰 최적화하고 서빙까지 마친 상태로 제공해, Private AI를 더 적은 GPU로 바로 운영할 수 있게 합니다.
GPU를 사기 전에 필요한 구성부터 확인해 보세요. 쓰려는 모델과 동시 사용자 수, 다루는 문서 길이를 알려 주시면, 그 조건에 맞는 GPU 구성과 예상 절감 폭을 검토해 드리고, 필요하면 PoC로 직접 확인할 수 있게 지원합니다.