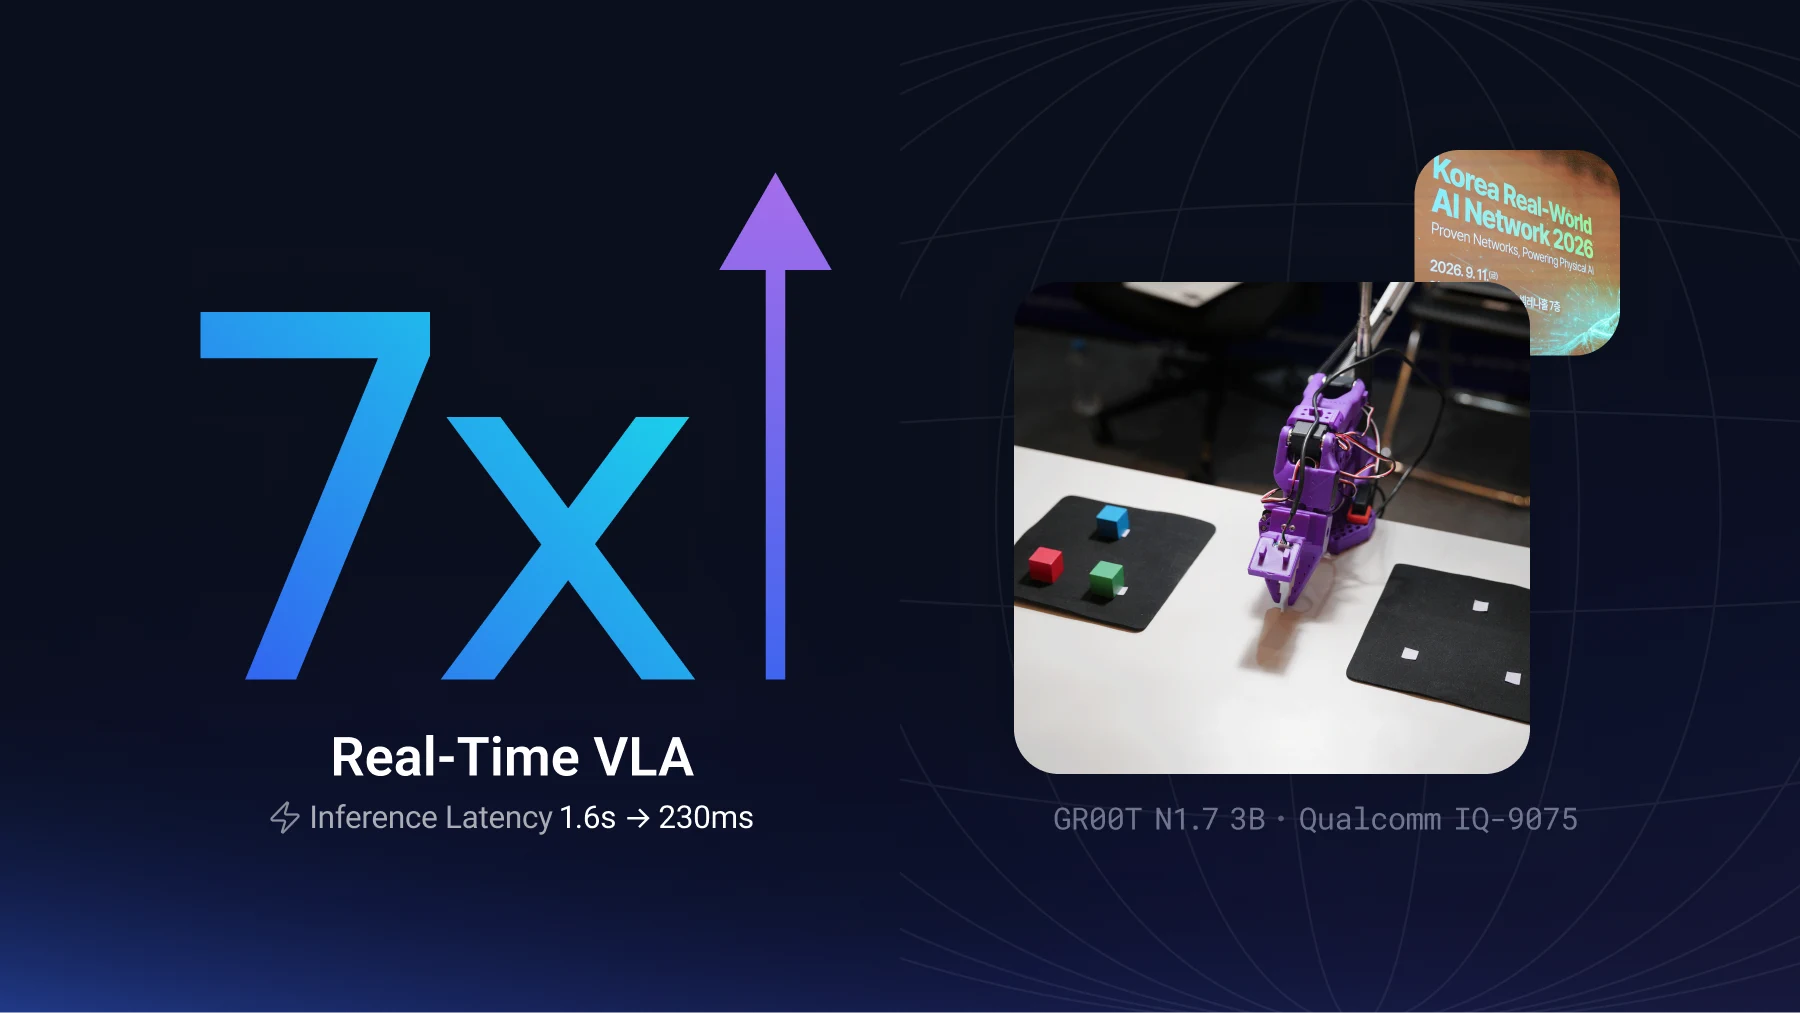
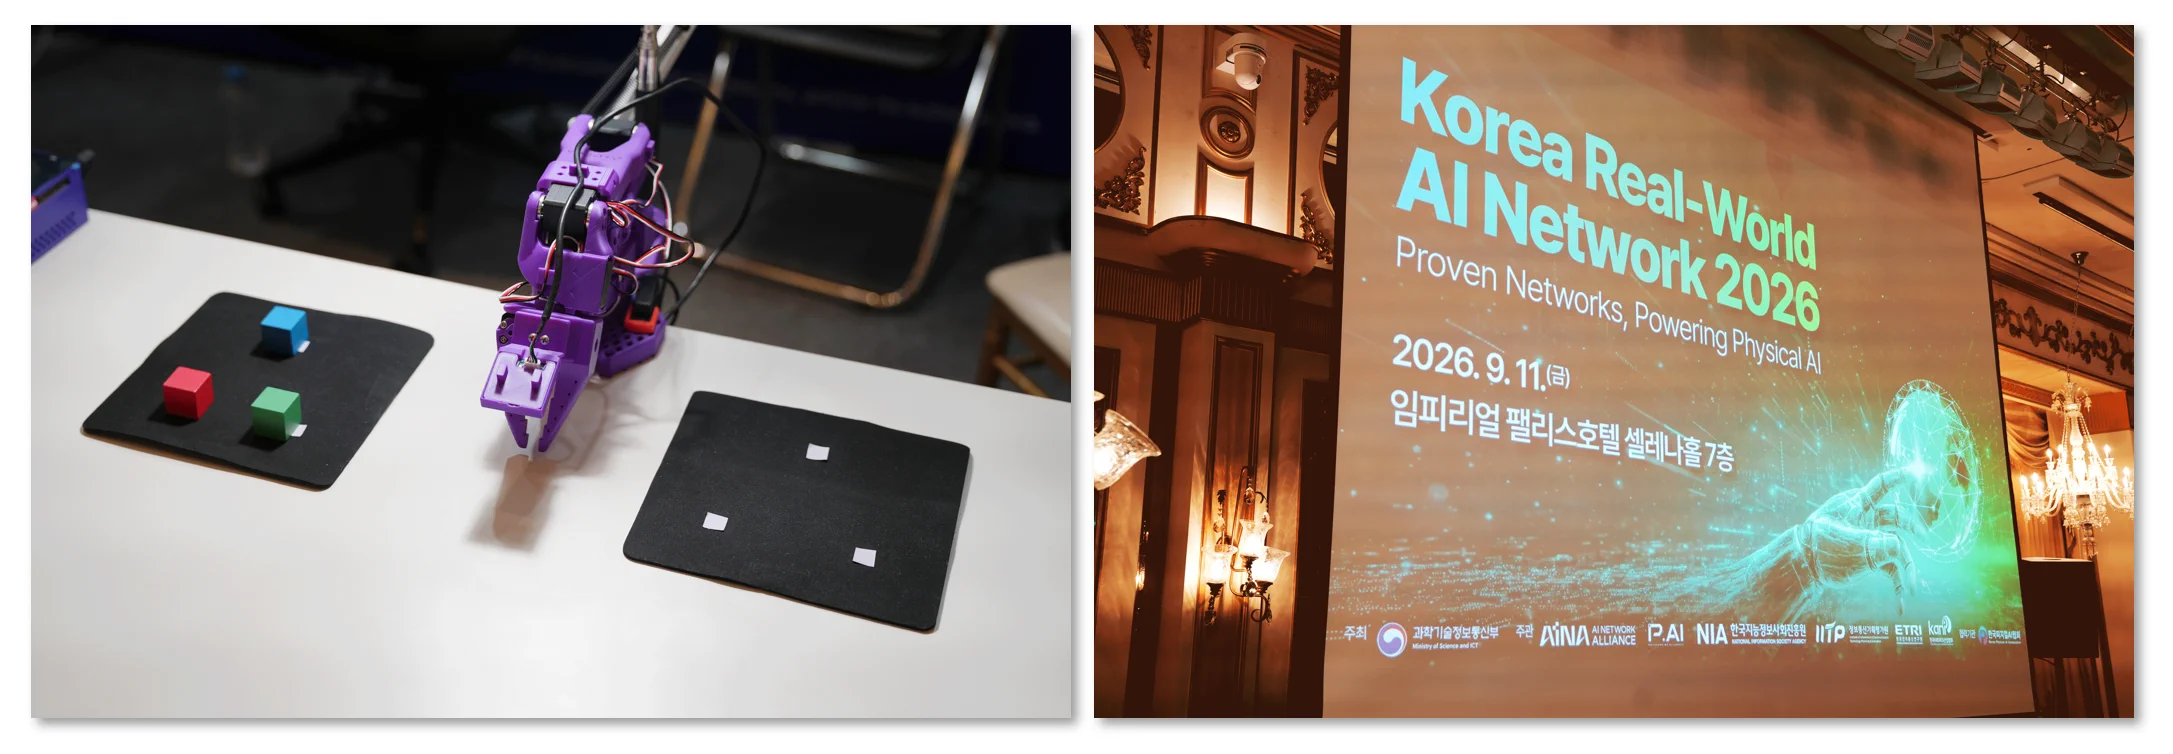
지난 9월 11일, 서울에서 KRAIN 2026(Korea Real-World AI Network) 전시가 열렸습니다. AI 네트워크와 피지컬 AI의 실증 사례가 모이는 자리였고, 노타는 VLA 모델 기반 SO-101 로봇팔 라이브 시연을 진행했습니다. 여러 색의 큐브가 놓인 매트에서 관람객이 색을 하나 고르면 로봇은 그 색만 집어 반대편으로 옮겼습니다. 이 로봇팔은 GPU 서버가 아니라 손바닥만 한 보드 위의 NPU(퀄컴 Dragonwing IQ-9075)로 움직였습니다.
VLA(Vision-Language-Action)는 카메라 프레임과 자연어 지시를 함께 받아 로봇 행동을 출력하는 모델로, 로봇 파운데이션 모델(RFM, Robotics Foundation Model)의 대표 갈래입니다. 보고, 판단하고, 다음 동작을 내놓는 일을 한 모델이 맡습니다. 매 프레임마다 이 과정 전부를 다시 계산하기 때문에, 제한된 NPU 자원 안에서 실시간으로 돌리는 일 자체가 병목입니다. 이 글은 그 병목을 푸는 과정에서 마주한 다섯 번의 판단을 정리했습니다.
배터리로 움직이는 로봇에게 연산 전력은 곧 가동 시간이고, 발열은 곧 팬과 부피입니다. 수백 대를 깔아야 하는 양산에서는 두뇌 보드의 가격이 사업성을 좌우합니다. 전력 대비 연산 효율에 맞춰 설계되고, 제어·비전·통신까지 한 칩에 통합된 NPU SoC가 이 자리에 들어가는 이유입니다. 최근 퀄컴이 멀티코어 NPU를 얹은 700 TOPS급 로봇용 SoC를 내놓고 인텔이 로봇 두뇌에서 GPU를 대체하겠다고 선언한 것도 같은 궤에 있습니다.
이 제약은 폼팩터를 가리지 않습니다. 관절이 많고 배터리를 스스로 지고 다녀 전력과 발열 예산이 빡빡한 휴머노이드는 물론, 현장에 많이 깔리는 바퀴 달린 이동 로봇(AMR)이나 고정형 로봇팔도 GPU 모듈을 통째로 얹기 어렵습니다. GPU 생태계에서 개발되고 시연되는 VLA를 결국 NPU 위로 옮겨와야 한다는 뜻입니다. KRAIN 데모에서 퀄컴 IQ-9075의 Hexagon NPU를 타깃으로 잡은 이유입니다.
그런데 가져다 바로 올릴 모델이 없습니다. LLM 발전이 그랬듯, RFM 업계는 지금 추론 효율보다 정확도와 범용성에 집중하고 있습니다. 어떤 환경, 어떤 로봇에서든 바로 동작하는 오픈소스 모델은 아직 없어 환경마다 파인튜닝이 필수입니다. SmolVLA처럼 경량 배포를 겨냥한 모델이 나오고는 있지만, 모델 시장이 초기라면 그 모델의 최적화는 더 초기일 수밖에 없습니다.
어떻게 옮기는지 알려주는 자료도 거의 없습니다. 연구 대부분이 GPU 연산을 전제로 이뤄지다 보니 공개되는 레이턴시는 H100 기준입니다. 방법론을 다룬 논문은 찾기 어렵고, 칩 벤더가 특정 모델 몇 개를 대상으로 낸 튜토리얼 정도가 전부입니다. 임베디드 NPU에서 같은 모델이 몇 배 느려지는지, 어디까지 최적화되는지, 백본별로 얼마나 다른지는 직접 올려보는 것 말고는 알 길이 없었습니다.
이번 시연에 쓴 SO-101(스탠다드 6-DoF 로봇팔)의 관절은 초당 30번 새 목표 각도를 받습니다(30Hz). 스텝 하나가 33ms마다 나와야 한다는 뜻입니다. 다만 VLA는 스텝을 하나씩 내놓지 않고, 한 번 관측해 액션 청크(여러 스텝을 묶은 행동 계획)를 통째로 냅니다. GR00T N1.7은 32스텝, MolmoAct2는 30스텝이니 청크 하나가 1초 안팎의 동작입니다. 추론 한 번에 주어지는 시간도 33ms가 아니라 이 1초입니다.
문제는 그 1초를 어디에 쓰느냐입니다. 기본 구성인 sync 모드는 청크를 다 쓴 뒤에 다음 관측과 추론을 하므로, 추론 시간이 그대로 팔의 정지 시간입니다. 추론이 1초면 1초 움직이고 1초 서 있습니다. 카메라와 로봇 자체의 지연까지 얹히니 기준은 정지를 어디까지 견디느냐로 정해지고, 그 값은 로봇과 태스크가 정합니다. Jetson Thor에서 flow matching 10-step MolmoAct2를 돌려보니 356~373ms 구간에서 큐브를 집어 옮기는 동작이 끊김 없이 이어졌습니다. 이 구간을 여유 있게 감싸 IQ-9075의 실시간 기준 320~400ms로 잡았습니다.
이 기준은 부드러움만의 문제가 아닙니다. 모델이 30 FPS 관측을 전제로 학습되기 때문에, 추론이 느려지면 로봇이 굼떠질 뿐 아니라 학습 분포와 어긋나 성공률 자체가 떨어질 수 있습니다.
첫 검토 백본으로는 MolmoAct2를 선택했습니다. 가중치가 공개되어 있어 SO-101 로봇팔에 맞춘 파인튜닝부터 연산 그래프 재작성까지 전 과정을 직접 제어할 수 있었기 때문입니다. 그러나 결론부터 말하면 이 백본은 최종 구성에 쓰지 않았습니다. 최적화를 극대화하더라도 목표 기준에 도달할 수 없었기 때문입니다.
기존 온디바이스 스택 위에 Baseline 그대로 얹은 IQ-9075의 관측-추론-행동 한 사이클(End-to-End, 이하 E2E) 지연 시간은 3,681ms였습니다. 목표 기준선(320~400ms)을 열 배 가까이 초과하는 수준입니다. 이 상태에서 실행 환경과 연산 그래프 차원의 최적화를 적용해 보았습니다.
그 과정에서 첫 걸림돌은 모델이 아니라 실행 환경이었습니다. VLA 한 사이클은 Vision Encoder, LLM, Action Head 세 부분이 순서대로 돕니다. 그런데 온디바이스 추론 스택은 모델 하나를 NPU 하나에 올리는 언어 모델 서빙 구조라, 이 세 부분을 두 NPU에 나눠 태울 방법이 없었습니다. NPU 두 개짜리 보드에서 하나가 통째로 놀고 있었다는 뜻입니다. 그래서 런타임을 직접 만들었습니다. NQRR(Nota QNN Robotics Runtime)입니다.
NQRR은 멀티 NPU 구조인 IQ-9075의 자원을 100%에 가깝게 쓰기 위해 만든 노타 자체 로보틱스 런타임입니다. VLA의 연산 그래프를 여러 NPU에 나눠 한 프로세스에서 실행하고, 모델 구조와 하드웨어 특성을 함께 보고 연산 배치와 데이터 전달 경로를 정했습니다. 변환된 그래프는 원본과 출력을 대조해 정합성을 확인했습니다.
그 위에서 정확도는 그대로 두고 그래프와 런타임만 고쳤습니다.
세 기법으로 각 모듈의 지연 시간을 30~60% 줄였고, E2E는 3,681ms에서 1,173.9ms로 68% 내려왔습니다.
1,173.9ms는 여전히 기준의 세 배에 가깝습니다. 지연이 어느 구간에 몰려 있는지 보려고, Action Head를 1스텝으로 압축한 배포 구성에서 구간별로 프로파일링했습니다.
측정 결과는 LLM 775.8ms, Vision Encoder 278.5ms, Action Head 136.6ms입니다. 비중이 가장 큰 LLM을 완전히 제거한다고 가정해도 Vision Encoder와 Action Head만으로 약 415ms입니다. 이미 실시간 기준을 넘어섭니다.
여기서 확인한 것은 기법의 한계가 아니라 구조의 한계였습니다. LLM 구간은 Softmax·Layer Normalization·Slice처럼 커널 런치 오버헤드가 큰 작은 연산들이 직렬로 늘어서 있어 양자화도 프루닝도 잘 듣지 않습니다. 듣는 것은 입력 시퀀스 길이를 줄이는 일인데, 그건 런타임이 아니라 모델 구조가 정합니다. 남은 방법은 백본을 바꾸는 것이었습니다.
다음 질문은 "어떤 백본으로 바꿀 것인가"입니다. 고를 기준은 MolmoAct2에서 이미 나왔습니다. 기법은 잘 들었고 막힌 것은 구조였으니, 같은 기법이 구조적으로 성립하는 백본을 찾으면 됩니다. SO-101에 적용할 수 있는 VLA 후보 12종에 네 가지 스크리닝 기준을 걸었습니다.
정확도는 스크리닝에서는 보지 않았습니다. VLA는 환경마다 파인튜닝이 필수라 문헌 정확도가 SO-101 위의 정확도를 말해주지 않기 때문입니다. 대신 직접 쟀습니다. 세 개 이상을 충족한 GR00T N1.7·VLA-JEPA·X-VLA·Pi-0.5에 기준선 MolmoAct2를 더한 5종을 IQ-9075와 NQRR 위에 나란히 올려 실측했습니다.
정확도는 LIBERO 폐루프 시뮬레이션에서 재고, 기법을 성공률 손실이 1%p를 넘기 직전까지 쌓았을 때의 가속 배수는 GR00T N1.7 7.0배(93% → 92%)·MolmoAct2 3.8배·X-VLA 2.7배·VLA-JEPA 2.1배·Pi-0.5 2.1배였습니다. 성립하는 기법이 구조마다 달라 백본에 따라 세 배 넘게 벌어졌습니다. 백본을 바꾸는 판단이 기법을 하나 더 얹는 판단보다 크게 작용한 지점입니다.
선정 기준은 둘이었습니다. 최적화 후 레이턴시, 그리고 SO-101 파인튜닝을 붙여 같은 태스크로 돌린 실기 성공률입니다. 배수는 얼마나 빨라지는지는 알려주지만 그 모델이 SO-101에서 큐브를 실제로 옮기는지는 알려주지 않기 때문입니다.
두 기준은 같은 답을 내지 않았습니다. 레이턴시 1위였던 백본은 GR00T가 아니었고, 그 백본의 실기 성공률은 5종 가운데 가장 낮았습니다. 두 기준을 함께 놓았을 때 남은 것은 GR00T N1.7입니다. 증류를 넣기 전 구성으로도 보드 위에서 400ms 수준으로 구동돼 실시간 기준 상단에 들어왔고, 실기 성공률은 80%였습니다. 최종 백본은 여기서 정해졌습니다.
백본이 정해졌으니 다시 그래프·런타임 최적화부터 시작했습니다. GR00T N1.7의 Baseline은 IQ-9075에서 1,602.4ms였습니다. 이번에는 하드웨어 특성에 맞추는 것을 목표로 잡았습니다. 아래 감소율은 E2E 기준입니다.
세 기법은 앞 단계 결과 위에 순차로 쌓은 것이고, 세 단계 뒤 E2E는 399.0ms입니다. 그래프와 런타임만 고쳐서 실시간 기준 상단에 닿았습니다. 백본 선정 평가에서 80%를 낸 구성이 이 지점입니다.
마지막으로 Step Distillation을 적용해 액션 청크 생성 스텝을 줄였습니다. 2-step 기준 287.4ms, 1-step 증류(drift)를 적용한 최신 체크포인트 기준 약 230ms입니다. Baseline 1,602.4ms 대비 약 7배이고, 실시간 기준(320~400ms)을 여유 있게 밑도는 지점입니다.
모델은 실시간 기준 안에 들어왔는데, 팔이 실제로 서 있는 시간은 501ms로 여전히 기준 밖이었습니다. 남은 몫은 제어 루프에 있었습니다.
첫 번째는 카메라 입력이었습니다. 모델이 1초 넘게 걸리던 동안에는 프레임당 약 96.5ms의 대기가 그 안에 묻혀 있었는데, 추론이 400ms 아래로 내려오자 이 몫이 그대로 드러났습니다. 제어 루프가 매번 동기로 프레임을 기다리는 구조였습니다. 카메라 스레드를 분리해 상시 최신 프레임을 버퍼에 갱신하고, 제어 루프는 버퍼를 참조만 하도록 바꿨습니다. 프레임 읽기 시간이 0.1ms 대로 내려왔고, 그 여파로 팔 정지 시간은 501ms에서 247ms로, 관측 지연은 700ms에서 58ms로 감소했습니다. 모델은 한 줄도 바꾸지 않았습니다.
두 번째는 액션 청크 경계의 jitter입니다. sync 모드에서 청크가 전환되는 순간 팔이 미세하게 튀는 현상이 관측됐습니다. 시간적 스무딩(LIPO 계열 알고리즘 참고 구현)을 얹어 open-loop 실측 기준 jerk RMS가 5.175에서 0.110으로 떨어졌습니다. 움직임이 매끄러워진 만큼 성공률이 유지되는지는 폐루프에서 따로 확인해야 하는 항목이었습니다.
세 번째는 n_action_steps 트레이드오프입니다. 16 / 24 / 32를 놓고 비교했을 때, 32까지 올려도 큰 정확도 하락은 관찰되지 않았고 팔의 움직임은 더 부드러워졌습니다. 다만 시도 횟수가 적어 정확도 차이를 단정할 단계는 아니었습니다. 대신 새 관측으로 재판단하는 주기가 길어져 반응성이 떨어지는 대가가 붙습니다. 기본값은 16으로 유지하고, 부드러움이 더 필요한 현장 조건에서는 24/32를 옵션으로 열어두는 형태로 정리했습니다. 이 값은 sync 모드의 파라미터입니다. 뒤에 나올 RTC 구성에서는 청크 32스텝을 그대로 씁니다.
전시에 올린 구성은 스텝을 덜 줄인 flow matching 모델에 RTC(Real-Time Chunking)를 얹은 것입니다. 230ms짜리 1-step 증류 모델은 전시에 오르지 않았습니다. RTC는 앞 청크가 실행되는 동안 다음 청크를 추론해 이어 붙이는 방식이라, sync 모드에서 정지 시간이던 추론이 팔의 이동 아래로 숨습니다. sync가 추론하는 순간에만 눈을 뜬다면, RTC는 움직이면서도 주기적으로 눈을 뜨는 셈입니다. 추론 한 번은 230ms보다 길어지지만, 앞 청크를 다 쓰기 전에 다음 추론이 끝나므로 팔은 서지 않습니다. 사람 없이 몇 시간을 돌려야 하는 자리에서 필요한 것은 매 사이클이 끊기지 않는 동작이었습니다.
RTC는 추론 지연을 로봇 동작 뒤로 숨기지만, 그만큼 실패도 가파릅니다. 추론이 청크 길이 안에 들어오면 정지 시간 없이 이어지고, 넘어서면 이어 붙일 것이 없어 심각한 에러가 발생합니다. MolmoAct2 시점 Jetson Thor 실측은 922ms로 그 한계를 한참 넘어서, 쓰면 반드시 깨지는 구성이라고 보고 기각했습니다.
GR00T N1.7에서는 구현을 바꿔 연산 오버헤드 없이 얹을 수 있었습니다. 다만 속도와 별개로 구조적 조건이 하나 더 붙습니다. RTC는 flow matching의 연속성을 이용하기 때문에, 스텝을 1까지 줄인 증류 모델에는 적용할 수 없습니다. 가장 빠른 230ms 모델이 정작 RTC를 못 쓰는 이유입니다.
전시 전 Jetson Thor에서 1시간 연속 구동으로 비교했습니다. 같은 flow matching 모델을 sync로 돌린 구성과 RTC를 얹은 구성입니다. RTC 쪽이 시간당 성공이 약 37% 많았고, 평균 성공 시간도 34.3초로 약 21% 짧았습니다. sync는 태스크를 끝낸 뒤에도 남은 청크를 마저 소모해야 해서 잉여 동작이 붙는데, RTC는 새 관측으로 곧장 다음 동작을 잡습니다.
성공률도 90%로 sync의 85.2%를 웃돌았습니다. 다만 시도 횟수를 감안하면 이 차이만으로 단정할 수는 없습니다. RTC가 확실히 앞선 것은 속도와 처리량입니다. IQ-9075 보드에서도 같은 구성이 정상 동작했습니다. 대신 같은 궤적을 가는 데 추론을 더 많이 돌리는 구성이라, 태스크가 단순하면 sync가 나을 수도 있습니다.
전시 부스의 SO-101은 관람객이 화면에서 색을 고르면 그 색 큐브를 집어 반대편 매트의 빈 Zone에 내려놓았습니다. 방해 큐브가 함께 놓여 있어 언어 지시로만 대상을 특정해야 하고, 놓은 자리가 다음 task의 시작 자리가 되는 연쇄 구성입니다. 큐브가 한곳에 몰리지 않게 Zone을 나눴고, 사람이 판을 정리해 주지 않는 것을 전제로 설계했습니다.
돌아간 구성은 앞의 다섯 판단 그대로입니다. 백본은 실기 성공률로 고른 GR00T N1.7, 런타임은 두 NPU를 함께 쓰는 NQRR, 그래프는 보드에 맞춰 다시 짠 것이고, 제어 루프에는 카메라 스레드 분리와 청크 경계 스무딩이 들어갔으며, 추론은 RTC로 이동과 동시에 진행했습니다. 어느 하나가 빠지면 팔이 서거나 판이 흐트러져 사람이 리셋해야 합니다. 이 전부가 손바닥만 한 IQ-9075 보드 하나 위에서 돌았습니다.
부스는 VIP 투어를 포함해 오후 내내 상시 운영됐습니다. 현장 성공률도 전시 전 Thor 테스트와 비슷한 90%를 유지했습니다.
보드 위에서 돈 다섯 판단을 층으로 묶으면 셋입니다. 백본을 고르고 스텝을 줄인 것은 모델, NQRR과 그래프 재작성은 런타임, 카메라 스레드에서 RTC까지는 제어입니다. 층마다 만든 것과 다음 프로젝트에 가져갈 원칙은 이렇습니다.
레퍼런스가 없는 모델군에서 수치는 출발점입니다. 같은 1,173.9ms를 보고도 더 깎을지 백본을 바꿀지가 갈리고, 같은 230ms를 두고도 그 수치를 쓸지 더 느리지만 서지 않는 구성을 쓸지가 갈립니다. 이 프로젝트의 갈림길 다섯 번이 전부 그런 자리였고, 판단을 대신해 준 것은 같은 보드·같은 태스크의 실측이었습니다. 그리고 마지막 갈림길은 모델 안에 있지도 않았습니다.
클라우드에서 레이턴시는 비용이지만, 로봇에서 레이턴시는 팔이 멈추는 물리적 실패입니다. 로봇의 두뇌 자리에 NPU가 늘고 그 위에 올릴 VLA가 더 커질수록 남는 질문은 하나입니다. 그 모델을 누가, 어떤 기준으로 가볍게 만드는가. 이번 KRAIN 데모는 그 질문에 실기로 답한 사례입니다. 같은 문제를 마주한 팀은 아래 링크로 문의해 주세요.
참고