2026년 8월 18일 독자 AI 파운데이션 모델(독파모) 2차 평가 결과가 나왔습니다. 8월 28일 모두의 AI 사업자가 선정됐고, 9월 8일 K-온디바이스 AI 반도체 휴머노이드 분야의 참여 기업이 공개됐습니다. 그리고 이 세 명단 모두에 노타가 있습니다.
세 사업의 목표는 저마다 다릅니다. ‘독파모’는 국가대표 AI 모델을 개발하고, ‘모두의 AI’는 국산 모델을 국민 서비스로 제공하며, ‘K-온디바이스 AI 반도체’는 모델을 국산 칩에 얹어 로봇을 움직입니다.
목표가 서로 다른 세 사업의 명단에 모두 노타가 포함된 것은 우연이 아닙니다. 사업의 성격은 달라도, 완성된 모델을 실제 구동할 하드웨어 규격에 맞춰 최적화해야 한다는 본질적인 과제는 동일하기 때문입니다. 노타가 세 자리에서 이 일을 맡게 된 배경은, 2015년 처음 마주했던 문제로 거슬러 올라갑니다.
노타는 2015년 4월 스마트폰 키보드의 오타를 고치는 앱으로 출발했습니다. 사명도 오타가 없다는 뜻의 No-Typo에서 왔습니다. 키보드 안에 AI를 넣으려 했을 때 부딪힌 문제는 모델을 잘 만드는 일이 아니라, 잘 만든 모델을 스마트폰의 메모리와 연산 능력 안에 들여놓는 일이었습니다. 모델을 줄이지 않으면 폰에 올라가지 않았고, 줄이면 정확도가 떨어졌습니다. 이 둘 사이에서 답을 찾는 일이 노타의 첫 문제였습니다.
2017년, 노타는 이 문제가 비단 키보드 앱 하나에 그치지 않을 것이라 판단했습니다. 그리고 그 해결을 회사의 정체성이자 핵심 미션으로 정의하고, 이듬해 AI 최적화 기업으로 전환했습니다.
당시 최적화 문제를 발견한 곳은 스마트폰이었지만, 이후 그 범위는 빠르게 넓어졌습니다. 모델 체급이 커지고 서비스 수요가 늘면서 데이터센터 GPU에서도 동일한 문제가 발생했고, 최근에는 시각과 언어 지시로 동작을 생성하는 모델이 등장하며 로봇 단말에서 직접 구동해야 하는 단계에 도달했습니다. 환경에 따라 하드웨어의 형태는 제각각이지만 문제의 본질은 같습니다. 주어진 하드웨어의 제약 안에 모델의 성능을 최대로 발휘하게 만드는 일입니다.
지난 8월과 9월에 공개된 세 명단은 이 최적화 문제가 지금 놓여 있는 세 자리에 하나씩 대응합니다. ‘독파모’는 모델, ‘모두의 AI’는 서비스, ‘K-온디바이스 AI 반도체’는 로봇이라는 자리를 각각 맡고 있습니다.
독파모는 과기정통부가 3년간 2,136억 원을 투입해 국가대표 AI 모델을 개발하는 사업입니다. 단계별 평가를 거쳐 현재 업스테이지, SK텔레콤, LG AI연구원 팀이 과제를 수행하고 있으며, 노타는 업스테이지 컨소시엄에 합류해 있습니다.
이 사업의 핵심 평가 기준은 '글로벌 빅테크 프론티어 모델 대비 95% 이상의 성능 확보'입니다. 이 기준을 충족하려면 모델의 체급(파라미터 수)은 확장될 수밖에 없습니다. 복잡한 추론 능력과 방대한 지식을 모델에 담으려면 그만큼 많은 파라미터가 필요하기 때문입니다. 실제로 업스테이지 팀의 Solar Open 모델은 반년 남짓 만에 파라미터 수가 1,000억 개(100B)에서 2,500억 개(250B)로 2.5배 늘어났습니다.
이처럼 모델의 체급이 커지면 추론 연산의 과부하를 줄이기 위해 전문가 혼합 구조(MoE)를 채택하는 것이 일반적입니다. 입력값에 따라 필요한 전문가 영역만 선택적으로 활성화하는 방식입니다. 다만 활성화되지 않는 전문가도 메모리에는 올라가 있어야 합니다. 가중치가 수백 GB에 달하면 그 용량이 곧 서빙에 필요한 GPU 대수를 결정합니다.
이 크기를 줄이는 대표적인 방법이 양자화입니다. 다만 정밀도를 낮추면 정확도가 떨어지기 쉽고, MoE 구조에서는 이 문제가 더 까다롭습니다. 전문가마다 가중치 분포가 다르고, 입력마다 어떤 전문가를 쓸지 고르는 라우팅(routing) 결과도 달라져서, 모든 전문가에 같은 방식을 적용하면 일부 전문가의 오차가 전체 성능을 떨어뜨립니다. 성능 기준을 맞추느라 커진 모델을 정확도를 지키며 서빙할 수 있는 크기로 줄이는 일, 이것이 독파모에서 노타가 맡은 과제입니다.
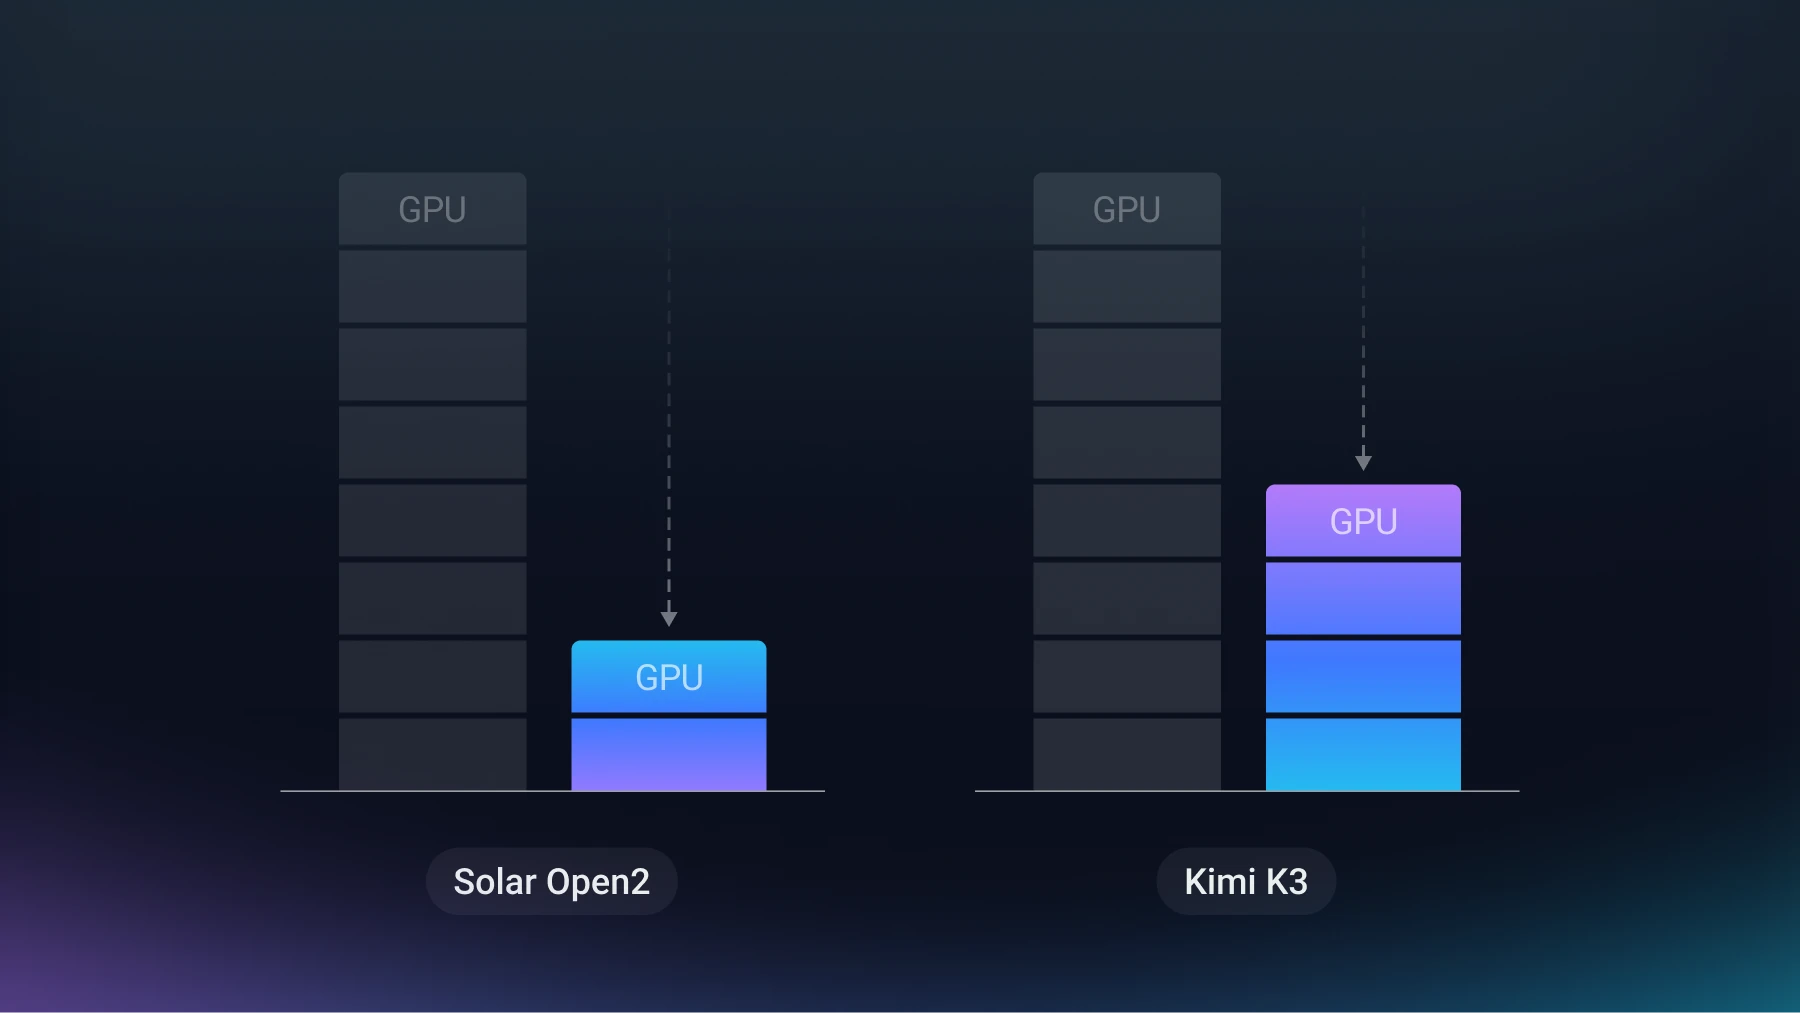
노타가 7월 공개한 Solar Open 2 경량화 모델이 이 과제에서 나온 결과입니다. 가중치 메모리를 500.6GB에서 117.8GB로 76.5% 줄여, 서빙에 필요한 H100 GPU를 8장에서 2장으로 낮췄습니다. 4비트 양자화에 가중치 가지치기(pruning)를 결합한 결과입니다. 서빙에 필요한 GPU가 줄어드는 만큼, 총소유비용(TCO) 측면의 비용 절감 효과도 기대할 수 있습니다.
이 바탕에는 MoE 구조 특유의 난제를 다루기 위한 세 가지 기술적 설계가 있습니다.
관련 방법론을 다룬 노타의 연구 논문 2편은 ICML 2026 워크숍에 채택되며 학계에도 소개됐습니다.
모두의 AI는 국산 AI 모델을 기반으로 국민 누구나 이용할 수 있는 서비스를 구현하는 과기정통부 사업입니다. 독파모에서 개발 중인 국산 모델들도 이 사업의 서비스 후보가 됩니다. 총 6개 팀 가운데 SK텔레콤·카카오·KT 컨소시엄이 최종 사업자로 선정되었습니다. 노타는 이 가운데 SK텔레콤 컨소시엄에 참여해 GPU 환경의 모델 경량화 부문에서 SK텔레콤과 협력합니다.
SK텔레콤 컨소시엄은 단순 대화형 챗봇을 넘어, 전화나 문자로 사용자의 요청을 직접 수행하는 '실행형 에이전트' 서비스를 지향합니다. 이용자를 대신해 전화를 수·발신하는 것은 물론, 병원 및 식당 예약처럼 필요한 시점에 AI가 먼저 연락을 취하는 기능까지 구상하고 있습니다. 이러한 에이전트 구조는 단 한 번의 사용자 지시에도 계획 수립, 도구 호출, 결과 검증, 재시도 루프를 거치기 때문에 단일 요청이 다수의 모델 호출로 이어집니다. 반면 서비스를 구동하기 위해 할당받은 GPU(B200) 자원은 제한적입니다.
여기에 사용자 수도 가파르게 늘어납니다. '모두의 AI'라는 사업 취지에 걸맞게 컨소시엄은 연내 월간 활성 사용자(MAU) 500만 명, 2027년 1,000만 명 달성을 목표로 설정했습니다. 독파모에서는 '모델 체급의 확장'이 핵심 변수였다면, 모두의 AI에서는 고정된 GPU 자원 안에서 '사용자당 호출 횟수와 전체 사용자 수의 동시 증가'를 해결해야 하는 구조입니다.
'전화'라는 음성 인터페이스는 응답 지연 시간(latency)의 기준을 더 엄격하게 만듭니다. 음성 통화에서는 응답이 2초만 늦어져도 사용자가 대화가 끊겼다고 느끼기 때문에, 보통 1~1.5초 안에 답해야 합니다. 결국 한정된 GPU 안에서 처리량을 늘리면서 지연 시간도 줄여야 합니다.
이러한 과제 역시 모델 경량화와 최적화를 통해 해결할 수 있습니다. 모델의 메모리 점유율과 연산량이 줄어들면, 동일한 GPU 인프라 환경에서 동시 처리할 수 있는 요청 수가 늘어나고 지연 시간 역시 유의미하게 줄어들기 때문입니다.
이 과정에서 노타가 지닌 강점은 축적된 실전 경험입니다. 서비스에 탑재될 A.X K2, Solar, K-EXAONE, Motif 등 4개 모델 계열 중, Solar와 K-EXAONE은 노타가 이미 직접 경량화를 수행해 본 대표적 라인업입니다. 특히 독파모에서 개발된 모델이 '모두의 AI' 서비스로 자연스럽게 이어지는 접점이기도 합니다.
대표적인 사례인 K-EXAONE-236B-A23B는 전체 2,360억 개 파라미터 가운데 토큰당 230억 개만 선택적으로 활성화되는 MoE 구조입니다. NVFP4는 B200이 포함된 엔비디아(NVIDIA) 블랙웰 세대 GPU가 하드웨어로 지원하는 4비트 포맷입니다. 노타는 AI 모델 최적화 플랫폼 넷츠프레소(NetsPresso®)로 이 모델을 NVFP4로 양자화했습니다. 단순한 포맷 변환이 아니라, 양자화 전에 가중치 분포를 NVFP4에 맞게 정돈하는 넷츠프레소 AQ의 자체 기법을 적용해 정확도 손실을 줄였습니다. 그 결과 모델 용량은 약 3.5배 줄어들었고, NVFP4 모델은 과학 추론(GPQA Diamond) 77.15점(원본 BF16 79.80점), 지시 이해(IFBench) 65.03점(원본 68.98점), 수학(AIME 2025) 89.33점(원본 88.57점)으로 세 평가 항목 모두 원본과 오차 범위 내의 정확도를 유지했습니다.
응답 속도에서도 개선 효과를 확인했습니다. 노타가 업스테이지의 Solar-Open-100B를 NVFP4로 양자화하여 B200과 동일한 블랙웰 세대인 B300 환경에서 동시 요청 8개 조건으로 측정한 결과, TTFT(time to first token)가 가중치만 4비트로 축소한 W4A16 방식 대비 2배 가깝게 단축되었습니다.
K-온디바이스 AI 반도체 기술개발사업은 2026년부터 2030년까지 총 8,002억 원(국비 5,111억 원)을 투입하여 4대 주요 산업용 국산 AI 칩 10종과 구동 소프트웨어를 개발하는 산업통상부 주관 사업입니다. 앞선 두 사업의 대상이 데이터센터의 GPU 서버였다면, 이번 사업에서는 모델이 올라갈 하드웨어의 종류 자체가 엣지 단말과 신경망 처리 장치(NPU) 환경으로 바뀝니다.
이 사업에서 노타는 휴머노이드 분야의 3세부 과제인 시각-언어-행동 모델(VLA) 최적화 소프트웨어를 주관합니다. 휴머노이드 분야는 LG전자가 시스템 개발을 총괄하고 모빌린트가 국산 NPU를 맡으며, 노타의 과제는 카메라 영상과 언어 지시를 받아 로봇의 동작을 내는 VLA를 모빌린트 NPU와 실제 로봇 환경에 맞춰 구동하는 일입니다. 로봇이 직접 보고 판단해 움직이는 피지컬 AI(Physical AI) 흐름에서 VLA는 핵심 모델로 꼽힙니다.
로봇과 같은 온디바이스 환경의 최적화는 GPU 서버와 방식이 다릅니다. 1만 개가 넘는 범용 코어로 임의의 연산을 처리하는 GPU와 달리, NPU는 하드웨어가 지원하는 연산자의 범위가 정해져 있습니다. 그래서 모델 그래프를 그대로 올릴 수 없고, NPU 구조에 맞춰 연산 그래프 자체를 다시 짜야 합니다. 예를 들어 NPU가 지원하지 않는 정규화(normalization) 레이어가 있으면, 칩이 지원하는 기본 연산자의 조합으로 분해해 연산 흐름을 재구성합니다.
여기에 VLA 모델 특유의 연산 병목이 겹칩니다. VLA는 비전 언어 모델(VLM)에 로봇의 행동을 출력하는 부분을 붙인 구조라, 실시간 카메라 영상이 만들어 내는 수많은 비전 토큰이 NPU의 메모리와 연산 유닛에 큰 부담을 줍니다. 결국 온디바이스 환경에서는 하드웨어 칩의 한계가 곧 모델 성능과 응답 속도의 상한선이 됩니다.
이 문제를 해결하려면 NPU 구조에 맞춘 최적화가 여러 단계에서 함께 작동해야 합니다. 노타는 각 단계별로 다음과 같이 접근합니다.
이러한 최적화 방법론은 상용 엣지 칩 환경에서 먼저 실증을 마쳤습니다. 노타는 퀄컴 NPU(Dragonwing IQ-9075)에서 VLA 5종의 최적화를 수행했습니다.
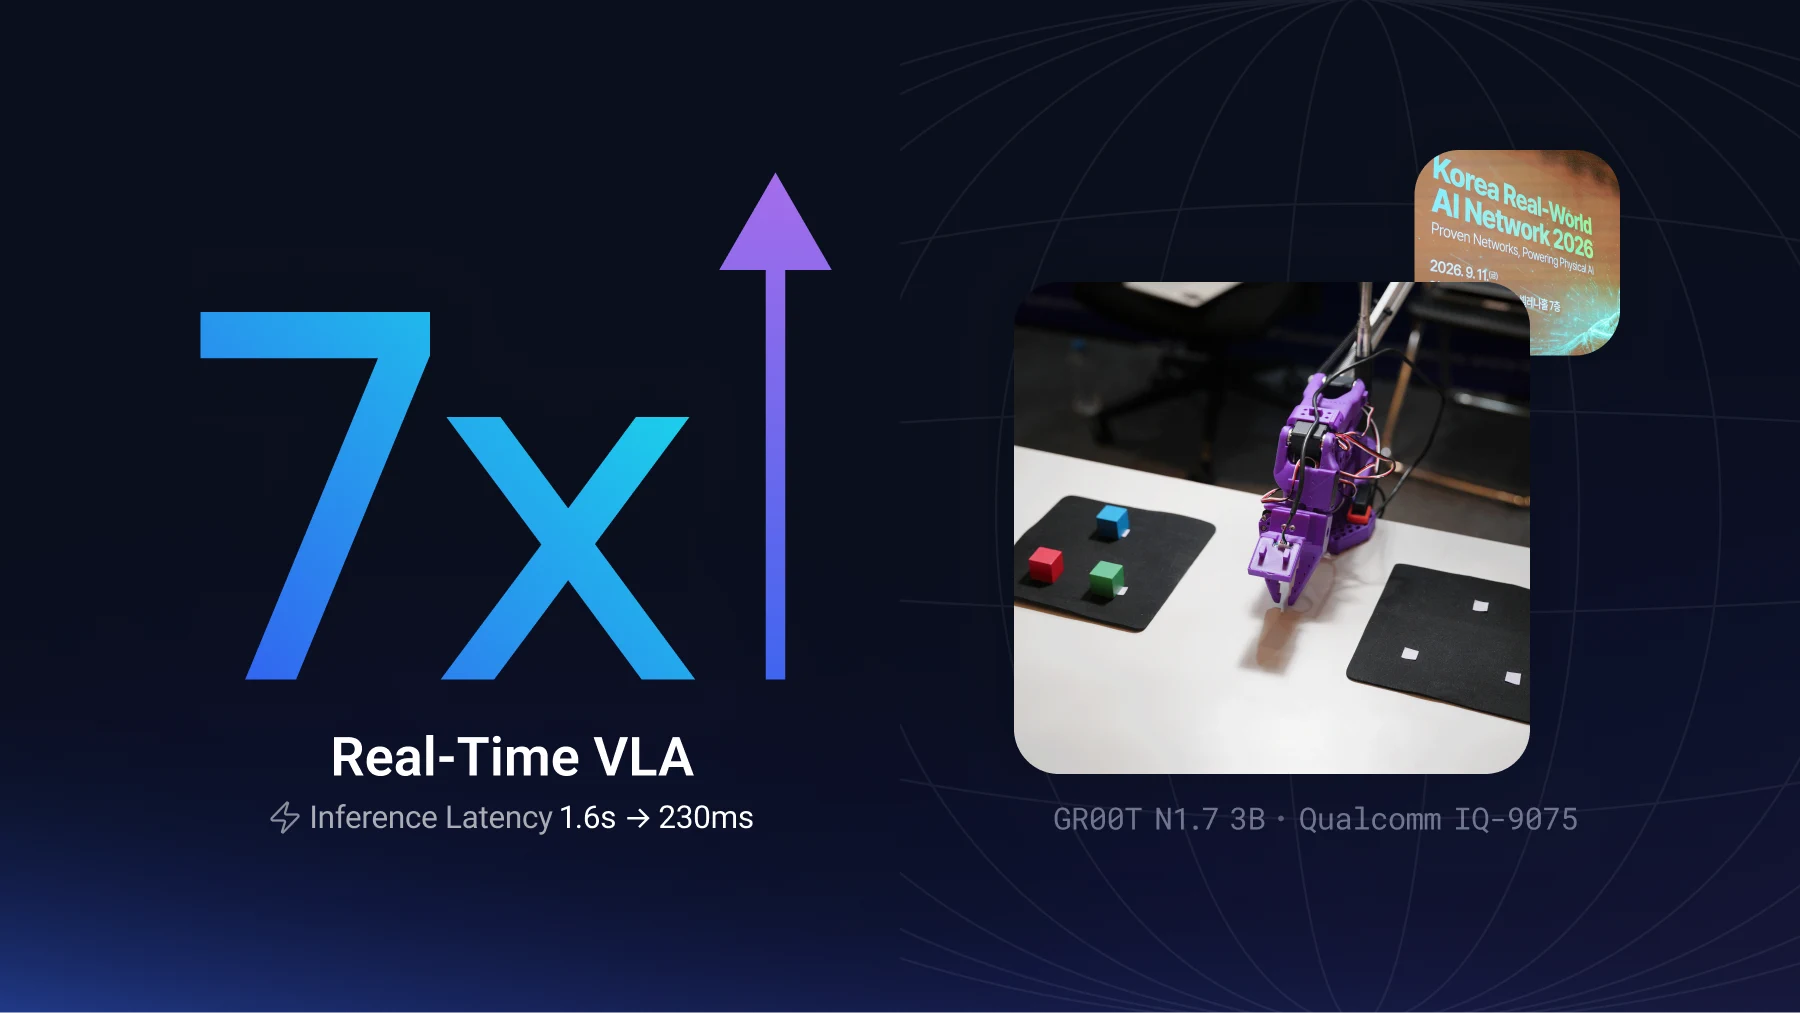
퀄컴 NPU 위의 엔비디아 GR00T N1.7은 추론 시간이 1,602ms에서 228ms로 약 7배 짧아졌고, 실제 로봇팔의 작업 속도는 3배 빨라졌습니다. 작업 성공률은 LIBERO 시뮬레이션 기준 원본 93%에서 92%로, 1%p 안에서 유지됐습니다. 노타는 상용 칩에서 검증한 이 방법을 이제 국산 NPU 위로 가져갑니다.
노타의 비전 'AI Everywhere'는 모든 디바이스에서 AI가 구동되는 환경을 뜻합니다. 그리고 이 비전은 지금 세 국가 사업의 현장에서 구현되고 있습니다. 노타는 국가대표 모델 후보인 Solar Open 2를 H100 GPU 2장에서 서빙되도록 압축하는 일, 국민 서비스에 탑재될 국산 모델을 B200 GPU 인프라에 맞게 최적화하는 일, 그리고 VLA 모델을 국산 NPU 위에서 구동하는 과제를 각각 맡았습니다.
세 자리의 하드웨어는 서로 다르지만, 노타는 하나의 플랫폼으로 세 자리를 오갑니다. 넷츠프레소는 AQ(Advanced Quantizer), GO(Graph Optimizer), GQ(Graph Quantizer)처럼 모델을 줄이고 하드웨어에 맞추는 과정을 하나의 흐름으로 묶었습니다. 서버에서 서빙할 LLM이든 엣지 칩에 올릴 모델이든, 타깃 하드웨어가 바뀌면 같은 흐름 안에서 그 하드웨어에 맞는 형태로 모델을 다듬습니다.
세 사업 명단에 노타가 모두 포함된 것은 'AI Everywhere'라는 비전이 단순한 선언에 머물지 않는다는 공개 기록입니다. 모델 개발, 서비스 상용화, 로봇 제어로 이어지는 각기 다른 세 사업이, 하드웨어에 모델을 맞추는 핵심 과제를 노타에게 동일하게 맡겼기 때문입니다. 넷츠프레소는 초소형 CPU부터 엣지 칩과 NPU, 데이터센터 GPU까지 지원합니다. 모델, 서비스, 로봇 세 자리의 하드웨어 전체가 이 범위에 포함됩니다.
어떤 하드웨어에서든 AI를 한계까지 최적화해 구동해 내는 것, 이것이 노타가 넷츠프레소로 증명해 가고 있는 'AI Everywhere'의 실제 모습입니다.