Press Release
October 1, 2026
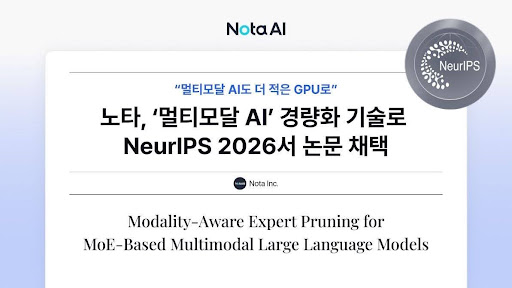
AI 모델 경량화 및 최적화 기술 기업 노타(대표 채명수)는 멀티모달 AI 모델의 성능 저하를 최소화하면서 GPU 메모리 사용량을 낮추는 연구 논문이 세계적인 AI 학술대회 ‘NeurIPS 2026’ 메인트랙에 채택됐다고 1일 밝혔다.
채택 논문은 ‘Modality-Aware Expert Pruning for MoE-Based Multimodal Large Language Models’다. 텍스트와 이미지 등 다양한 정보를 함께 처리하는 멀티모달 AI에 맞춰 ‘전문가 프루닝’ 기술을 고도화했다. 전문가 혼합(MoE·Mixture of Experts) 모델의 일부 전문가 모듈을 제거할 때 언어와 이미지 이해 능력을 함께 고려해 성능과 구동 효율을 균형 있게 확보하는 것이 핵심이다.
성능 평가에서는 약 310억 파라미터의 멀티모달 모델에서 전문가 모듈을 25% 제거했을 때 원본 성능의 98%를, 50% 제거했을 때는 91%를 유지했다. GPU 메모리 사용량은 58GB에서 31GB로 약 47% 줄어 40GB 메모리를 갖춘 GPU 한 장으로 구동할 수 있는 수준을 확보했다.
이는 최신 AI 모델을 도입하기 위해 반드시 더 많은 고사양 GPU를 추가해야 하는 것이 아니라, 소프트웨어 최적화를 통해 기업이 보유한 AI 인프라의 활용도를 높일 수 있다는 의미다. 모델 구동에 필요한 메모리를 줄이면 같은 GPU 자원에서 활용할 수 있는 모델의 범위를 넓히거나 확보한 여유 자원을 다른 모델과 서비스에 배분할 수 있어 기업은 최신 AI 도입과 운영에 필요한 인프라 부담을 낮출 수 있다.
MoE는 여러 전문가 모듈 가운데 입력에 필요한 일부를 선택해 연산하는 AI 모델 구조다. 연산에 참여하는 전문가가 일부여도 전체 전문가를 저장할 메모리가 필요해 모델 규모가 커질수록 구동 부담이 높아진다. 전문가 프루닝은 상대적으로 중요도가 낮은 전문가를 제거해 이러한 부담을 줄이는 기술이다. 다만 기존 언어모델용 방식을 멀티모달 모델에 그대로 적용하면 이미지 이해에 필요한 전문가까지 제거될 수 있다. 실제 연구에서도 차트 이해 등 이미지 정보가 중요한 과제에서 성능이 크게 떨어지는 문제가 확인됐다.
노타는 이를 해결하기 위해 텍스트와 이미지에 대한 전문가의 중요도를 각각 평가했다. 텍스트 기준 중요도는 유지할 전문가를, 이미지 기준 중요도는 제거할 전문가를 선정하는 데 활용해 두 능력을 균형 있게 보존하도록 했다. 또 모델의 각 층에서 같은 수의 전문가를 제거하는 대신, 모델 전체의 전문가를 비교해 중요한 층에 필요한 전문가가 유지되도록 했다.
추가 학습 없이 한 차례의 압축 과정으로 경량화를 완료할 수 있다는 점도 강점이다. 사용자가 전문가 제거 비율만 설정하면 적용할 수 있어 새로운 파운데이션 모델이 공개될 때도 빠르게 대응할 수 있다.
노타는 이번 기술을 자사의 AI 최적화 플랫폼 ‘넷츠프레소’에 반영해 멀티모달과 MoE 모델 역량을 더욱 강화할 계획이다. 최신 AI 모델이 텍스트 중심에서 이미지와 영상, 음성 등을 함께 처리하는 멀티모달 모델로 빠르게 확장되고 있는 만큼, 넷츠프레소가 지원하는 AI 모델과 고객 적용 범위를 넓힌다는 구상이다.
이번 연구로 텍스트 전용 대규모 언어모델(LLM)뿐 아니라 이미지와 언어를 함께 처리하는 비전언어모델(VLM)까지 대응할 수 있는 기술 기반을 강화했다. 입력 정보별로 전문가의 중요도를 평가하는 이번 연구의 원리는 향후 영상과 음성 등으로도 적용 범위를 확대할 수 있을 것으로 기대된다.
노타는 앞서 ‘키미 K3’와 ‘솔라 오픈 2’ 등 초거대 모델에 전문가 프루닝을 적용하며 최적화 경험을 축적해 왔다. 올해에만 세계적인 AI 학회인 ICLR, EMNLP, ICML에 이어 NeurIPS에서도 연구 성과를 인정받으며 AI 최적화 분야의 기술 경쟁력을 입증했다.
채명수 노타 대표는 “AI 모델이 텍스트 중심의 LLM에서 이미지와 영상, 음성을 함께 이해하는 멀티모달 AI로 발전하면서 모델 규모와 GPU 메모리 부담도 빠르게 커지고 있다”며 “이번 연구는 모델 성능을 유지하면서 필요한 컴퓨팅 자원을 크게 줄일 수 있다는 점에서 실제 AI 인프라 운영 효율을 높이는 데 의미가 크다”고 말했다.
이어 “노타는 초거대 언어모델에서 축적해 온 최적화 역량을 멀티모달 AI까지 확대하고 있으며, 최신 연구 성과를 넷츠프레소에 지속적으로 반영하고 있다”며 “AI 모델이 커지고 복잡해질수록 기업이 보유한 GPU와 AI 인프라를 보다 효율적으로 활용할 수 있도록 지원하는 최적화 기술의 가치도 더욱 커질 것”이라고 말했다.